Вопросы и ответы · простым языком

Частые вопросы об ИИ и языковых моделях

Ответы на вопросы, которые чаще всего задают о машинном обучении, языковых моделях и агентах. Вопросы идут от простого к сложному: сначала – что такое модель и токен, в конце – агенты, подключение к сервисам, своя база знаний, автоматизация без программирования (n8n) и формат Markdown, в котором лежат материалы курса. Каждый ответ начинается с короткой версии, ниже – подробности и ссылки на источники. Сведения о сервисах, ценах и условиях приведены на 15.11.2026, они меняются часто. Незнакомые слова объяснены в глоссарии.

43 вопросаот простого к сложному

01 · раздел

ИИ, машинное обучение и языковые модели

1 Что такое машинное обучение (ML) и что такое большая языковая модель (LLM)? Это одно и то же?

Коротко

Нет, но одно входит в другое. Машинное обучение – подход, при котором программа не получает правила от человека, а сама подбирает их по примерам. Большая языковая модель – один из результатов такого подхода: огромная нейронная сеть, обученная на текстах. Любая языковая модель – это машинное обучение, но не всякое машинное обучение – языковая модель.

В России термины ИИ закреплены в национальном стандарте ГОСТ Р 71476-2024, он действует с 1 января 2025 года [1]. Машинное обучение там определено как «процесс оптимизации параметров модели с помощью вычислительных методов таким образом, чтобы поведение модели отражало данные и/или опыт» [1]. Проще: модель подстраивают под примеры, пока она не начнёт давать нужный результат.

Нейронная сеть по тому же стандарту – сеть из слоёв нейронов, соединённых связями с регулируемыми весами [1]. Большая языковая модель – нейронная сеть с миллиардами параметров, обученная на огромном объёме текстов предсказывать продолжение текста. Отдельного термина «большая языковая модель» в стандарте нет [1].

Искусственный интеллект, машинное обучение и языковые модели: что во что входит
Искусственный интеллект, машинное обучение и языковые модели: что во что входит – интерактивная схема

Посмотреть, как маленькая нейронная сеть учится распознавать цифры, можно в браузере, в лаборатории «Цифра. Слой за слоем»: https://neural-network-digit-recognition.pikov.expert/ [2].

К списку вопросов ↑

2 Когда применяют машинное обучение, а когда – языковую модель?

Коротко

Если данные – числа и таблицы (замеры, показания датчиков, журналы испытаний) и нужен прогноз, класс или группировка, это задача классического машинного обучения. Если нужно работать с текстом – прочитать, пересказать, сравнить, составить, ответить на вопрос по документу, – это задача для языковой модели. Многие рабочие системы сочетают оба подхода.

Стандарт называет типичные задачи машинного обучения: классификация, регрессия, ранжирование, кластеризация и понижение размерности [1]. Справочник библиотеки scikit-learn описывает их на примерах: классификация отвечает, к какой категории относится объект; регрессия предсказывает числовое значение; кластеризация объединяет похожие объекты в группы [3].

Задача Чем решать
Предсказать отказ узла по току, напряжению и температуре Классическое машинное обучение
Найти на фото дефект сварного шва Нейронная сеть для изображений
Сравнить техническое задание с протоколом испытаний и найти расхождения Языковая модель
Составить черновик письма поставщику по таблице замечаний Языковая модель

Точный расчёт лучше не поручать языковой модели: в многошаговых вычислениях она ошибается. Разумная схема – модель предлагает и объясняет, а считает и проверяет программа (темы 1.1 и 5.1 курса).

К списку вопросов ↑

3 Что нужно купить, скачать или открыть, чтобы начать?

Коротко

Покупать ничего не нужно. Для языковой модели достаточно браузера и учётной записи в сервисе. На работе – в том сервисе, который разрешён в организации. Для классического машинного обучения бесплатны и язык Python, и библиотека scikit-learn, и среда Jupyter. Платить имеет смысл позже: за подписку с большими лимитами или за видеокарту, если модели нужно запускать у себя (вывод автора).

Языковая модель:

  • чат в браузере – на курсе это GigaChat и Алиса AI (тема 1.1);
  • программный доступ для своих программ, например GigaChat API: на странице тарифов для частных лиц указан бесплатный режим Freemium – 365 млн токенов на 12 месяцев; страница оговаривает, что это тарифы для действующих клиентов, а новые клиенты с 1 сентября 2026 года оплачивают работу с моделями на платформе cloud.ru [4];
  • модель на своём компьютере – программы Ollama, LM Studio и другие (вопрос 24).

Классическое машинное обучение:

  • Python – бесплатный язык с открытой лицензией, в том числе для коммерческого использования [5];
  • scikit-learn – открытая библиотека «простых и эффективных инструментов для анализа данных» [3];
  • Jupyter – среда, где код, таблицы и графики лежат в одном документе; попробовать её можно прямо в браузере [6].

Рабочие данные – только в разрешённые сервисы. Почему это правило строгое, разбирается в теме 2.1.

К списку вопросов ↑

02 · раздел

Что такое модель

Модель – это файлы с числами, и от их размера зависит, где модель может работать.

4 Что такое модель: файл, программа или сервис? Можно ли её увидеть?

Коротко

Сама модель – это файлы с миллиардами чисел, которые подобрали при обучении; их называют параметрами или весами. Чтобы модель работала, нужна программа, которая загружает эти файлы и считает по ним ответ. В чат-сервисе файлы лежат на серверах поставщика, и вы видите только окно чата. Открытые модели можно скачать и увидеть сами файлы.

Пример – открытая модель OpenAI gpt-oss-20b. В её карточке на Hugging Face указано 21 млрд параметров, а веса лежат в трёх файлах примерно по 4–5 ГБ [7]. Форматы файлов называются safetensors и GGUF; второй хранит вместе с числами описание модели и подходит для программ Ollama, LM Studio, GPT4All и llama.cpp [8], [9]. Есть и российские открытые модели: например, YandexGPT 5 Lite на 8 млрд параметров выложена в том числе в формате GGUF [10].

У закрытых моделей размер обычно не раскрывают. В техническом отчёте о GPT-4 OpenAI прямо пишет, что не приводит подробностей архитектуры, включая размер модели [11]. У Anthropic на странице прозрачности числа параметров нет ни у одной модели [12].

Как посмотреть своими глазами:

  • открыть страницу модели на Hugging Face и вкладку с файлами;
  • поставить Ollama или LM Studio и скачать небольшую модель – она займёт несколько гигабайт на диске;
  • увидеть устройство маленькой нейронной сети изнутри – в лаборатории «Цифра. Слой за слоем» [2].

К списку вопросов ↑

5 Почему моделей так много и что означают цифры в названиях?

Коротко

Разработчики выпускают линейки: большая модель умнее, но медленнее и дороже, маленькая – быстрее и дешевле. И обновляют их несколько раз в год. Цифры в названии чаще всего означают номер поколения или размер модели в миллиардах параметров. Остальные слова подсказывают назначение.

Примеры по описаниям разработчиков:

  • Claude (Anthropic). В 2024 году Anthropic перечисляла линейки Haiku, Sonnet и Opus «по возрастанию возможностей» [13]; в 2026 году над Opus появился класс Fable и Mythos [14]. Номер в названии – поколение и версия внутри него: Claude Sonnet 5, Claude Opus 5.5. Обновлённая версия выходит под новым идентификатором [15].
  • GigaChat (Сбер). GigaChat 2 Lite – «быстрая и легкая модель для простых повседневных задач», Pro – для ресурсоёмких задач, Max – «для самых сложных и масштабных задач» [16].
  • YandexGPT (Яндекс). Lite – где важна скорость ответа, Pro – для сложных задач, например ответов на вопросы по документации [17].
  • Qwen (Alibaba). В названии Qwen3-235B-A22B: 235 млрд параметров всего и 22 млрд активных при обработке каждого токена [18]. У версий Qwen3-235B-A22B-…-2507 вариант Instruct работает только без рассуждения, а Thinking – только с рассуждением [19], [20].

Буква B после числа – миллиарды параметров (billion): 8B – 8 миллиардов. Смысл некоторых частей названий разработчики не объясняют, тогда его лучше не угадывать.

К списку вопросов ↑

6 Почему модель не запустить на домашнем компьютере, ноутбуке или планшете и зачем нужны очень дорогие компьютеры?

Коротко

Все веса модели должны поместиться в память, а для быстрой работы – в память видеокарты. На каждый токен модель считает по своим весам. У игровых видеокарт 12–32 ГБ памяти, а крупные модели занимают сотни гигабайт. Поэтому их запускают на серверах, где стоит несколько ускорителей по 80–141 ГБ. Небольшие открытые модели в сжатом виде работают и на домашнем компьютере, лучше – с хорошей видеокартой.

Объём памяти у современных устройств NVIDIA: игровые RTX 5070 – 12 ГБ, RTX 5070 Ti – 16 ГБ, RTX 5090 – 32 ГБ [21], [22]; серверные H100 – 80 или 94 ГБ, H200 – 141 ГБ [23], [24]; система DGX B200 из восьми ускорителей – 1440 ГБ на всех [25]. Цены серверных ускорителей NVIDIA на своих страницах не публикует.

Простая оценка (вывод автора): в обычном виде один параметр занимает 2 байта. Значит, модели на 235 млрд параметров нужно около 470 ГБ только под веса – это несколько серверных ускорителей. На каждый токен обычная модель выполняет примерно по две операции на каждый параметр [26]. У моделей со «смесью экспертов» на токен работает только часть параметров: у Qwen3-235B-A22B – 22 млрд из 235 млрд [18].

Выручает сжатие – квантование: параметры хранят в 3–4 битах вместо 16. В исследовании 2022 года так удалось уменьшить модели в несколько раз почти без потери точности и впервые запустить модель на 175 млрд параметров на одной видеокарте [27]. Но в другой работе ни один из проверенных способов не сохранил при 4 битах исходное качество полностью [28]. Сжатые модели и раздают для домашних программ: формат GGUF с уровнем Q4_K – около 4,5 бита на параметр [9].

Что работает дома:

  • программа LM Studio для Windows рекомендует хотя бы 16 ГБ оперативной памяти и 4 ГБ видеопамяти [29];
  • открытая модель gpt-oss-20b, по описанию в каталоге Ollama, запускается на системах с 16 ГБ памяти [30];
  • в исследовании 2026 года рабочая станция с одной потребительской видеокартой выдавала 29–65 токенов в секунду на задачах помощника по документам и программам [31].

Без видеокарты модель можно запустить на процессоре: так умеет, например, GPT4All [32]. На ноутбуке без отдельной видеокарты и на планшете памяти и мощности меньше, поэтому там работают только маленькие модели, и те медленно (вывод автора).

К списку вопросов ↑

03 · раздел

Токены: как модель читает текст

7 Что такое токен и как посмотреть, на какие токены делятся слова?

Коротко

Токен – кусочек текста, с которым работает модель: короткое слово целиком, часть длинного слова, знак препинания. Модель читает и пишет текст токенами, и всё считается в токенах: длина запроса, объём «памяти» диалога, лимиты, цена. Посмотреть деление можно в бесплатных онлайн-токенизаторах.

Пример. Слово «непредсказуемость» токенизатор моделей Qwen 2.5 делит на 8 токенов: «н», «еп», «ред», «с», «каз», «у», «ем», «ость». Английское «unpredictability» – на 3: «un», «predict», «ability» [33]. У каждого семейства моделей свой словарь, поэтому то же русское слово у GPT-4o занимает 6 токенов, а у GPT-4 – 8 [34], [35].

Где посмотреть самому:

  • Токенизатор OpenAI – раскрашивает токены и считает их для словарей моделей OpenAI; 15.11.2026 открывался без входа, «непредсказуемость» на словаре GPT-5.x – 6 токенов [36];
  • Tiktokenizer – показывает токены и их номера для словарей моделей OpenAI; 15.11.2026 открывался без входа и принимал русский текст [34];
  • The Tokenizer Playground на Hugging Face – раскрашивает токены; словарь выбирается из списка: GPT-4, Llama 3, Mistral, Gemma и другие; 15.11.2026 открывался без входа и принимал русский текст [35].

Посчитать токены программно можно и у российских сервисов: у GigaChat API для этого есть отдельный запрос [37], у Yandex AI Studio – бесплатный метод, для которого нужна учётная запись в облаке [38].

Ориентиры от разработчиков: для английского текста токен – примерно 4 символа или три четверти слова [36]; у GigaChat – в среднем 3–4 символа [37]; у Anthropic размер токена зависит от модели и языка [39].

К списку вопросов ↑

8 Почему на русский текст уходит больше токенов, чем на английский?

Коротко

Словарь токенов составляют по большим массивам текстов, и английского в них больше всего. Частые английские слова попадают в словарь целиком, а русские чаще режутся на части. К тому же у русских слов много форм: «модель», «модели», «моделью» – разные цепочки букв. В итоге тот же смысл по-русски стоит больше токенов.

Замер 15.11.2026. Взят официальный текст Всеобщей декларации прав человека, статьи 1–30, с сайта ООН – по-русски и по-английски [40]. Русский вариант короче по числу слов (1343 против 1420), но токенов в нём больше у всех четырёх проверенных открытых моделей [33]:

Модель Русский текст, токенов Английский текст, токенов Во сколько раз больше
Qwen 3.5, 9 млрд параметров 2209 1627 1,36
Gemma 3, 4 млрд 2266 1620 1,40
gpt-oss, 20 млрд 2308 1608 1,44
DeepSeek-R1, 14 млрд, на основе Qwen 2.5 2957 1630 1,81

На английское слово пришлось 1,13–1,15 токена, на русское – 1,64–2,20 [33].

Исследования подтверждают это на десятках языков. Число токенов у одного и того же текста в переводе на разные языки может различаться до 15 раз, и разрыв остаётся даже у словарей, обученных на многих языках [41]. Что считать токеном, зависит от данных, на которых обучали модель, и носители многих языков платят за доступ к модели больше, а ответы получают хуже [42]. Больше всего токенов тратят языки с нелатинским письмом и богатыми окончаниями [43].

Разработчики моделей с упором на русский язык подстраивают под него словарь. Т-Банк пишет, что его модели T-lite и T-pro быстрее генерируют русский текст за счёт оптимизированного токенизатора [44], [45]. В таблице-примере Яндекса модель YandexGPT Pro укладывает в токен в среднем 5,39 символа русского текста, а DeepSeek – 4,04 [38].

Что это значит на практике (вывод автора):

  • через программный доступ русский запрос стоит дороже английского того же смысла;
  • лимиты подписки расходуются быстрее;
  • в контекстное окно помещается меньше русского текста.

К списку вопросов ↑

9 Что происходит с токенами дальше и что получает модель на вход?

Коротко

Модель получает не буквы, а номера токенов. Каждый номер она заменяет длинным набором чисел – вектором – и прогоняет эти наборы через десятки слоёв. На выходе – вероятности для следующего токена. Модель выбирает один, дописывает его к тексту и повторяет, пока ответ не закончится.

По шагам:

  1. Токенизатор режет текст на токены и заменяет каждый его номером в словаре. В словаре моделей Qwen 2.5 – 151 676 токенов вместе со служебными [33].
  2. Каждый номер превращается в вектор. У четырёх моделей, проверенных на компьютере автора, это от 2560 до 5120 чисел на токен [33].
  3. Слои модели сопоставляют все токены друг с другом. Этот механизм называется вниманием; на нём построен трансформер [46] – архитектура современных языковых моделей.
  4. На выходе модель получает вероятности для следующего токена и выбирает один [47].
  5. Выбранный токен добавляется к тексту, и всё повторяется.
Что происходит с текстом внутри языковой модели
Что происходит с текстом внутри языковой модели – интерактивная схема

На входе модель получает то, что сервис собрал для текущего запроса: инструкции, доступную часть диалога, приложенные материалы или найденные в них фрагменты. Объём этого входа ограничен контекстным окном. Например, у моделей Claude окно – 1 млн токенов, по оценке Anthropic это около 555 тыс. слов [48]. На каждый токен модель делает работу, пропорциональную числу задействованных параметров [26], поэтому длинный диалог и большая модель – это больше вычислений.

К списку вопросов ↑

10 Почему модель на один и тот же вопрос отвечает по-разному?

Коротко

Модель выбирает следующий токен с долей случайности, чтобы текст был разнообразнее, поэтому два ответа на один вопрос расходятся. Даже если случайность отключить, ответы всё равно могут различаться: сервер считает одновременно много запросов, и порядок вычислений немного меняется от раза к разу.

В исследовании, где ChatGPT писал программы, доля задач, в которых ответы на одинаковый запрос ни разу не совпали по результатам тестов, – от 47,56 до 75,76 % в зависимости от набора. Отказ от случайного выбора (температура 0) разброс уменьшил, но не убрал [47]. Anthropic в своей документации предупреждает о том же: даже при температуре 0 ответы не полностью детерминированы [39].

Лаборатория Thinking Machines показала это на опыте: 1000 ответов модели Qwen3-235B на один запрос при температуре 0 дали 80 разных текстов. Главная причина в том, что нагрузка на сервер, а значит, и размер пакета запросов меняются непредсказуемо [49]. Исследователи системного программного обеспечения объясняют механизм так же: вычисления с плавающей точкой дают немного разный результат при разном порядке сложения, а порядок зависит от того, сколько запросов сервер обрабатывает вместе [50].

На новых моделях пользователь всё чаще не может управлять случайностью: в новой версии API Anthropic параметр температуры убран совсем [51], а у моделей Gemini начиная с 3.6 Flash он игнорируется [52]. Поэтому исследователи советуют считать ответ модели выборкой из множества возможных, а не точным измерением [53].

Что делать: если факт важен, задайте вопрос ещё раз в новом чате и сравните. Если ответы противоречат друг другу, модель, скорее всего, сочиняет [54]. Совпадение проверку не заменяет: модель может уверенно повторять одну и ту же ошибку (тема 1.1).

К списку вопросов ↑

04 · раздел

Текст и изображения

11 Почему одни модели работают только с текстом, а другие – и с изображениями?

Коротко

Чтобы модель «видела», к ней добавляют отдельный блок – кодировщик изображений – и дообучают на парах «картинка и текст». Модель, которую так не учили, принять картинку не может. Многие современные модели принимают изображения, но есть и чисто текстовые.

В типичной схеме кодировщик превращает картинку в векторы, а связующий блок переводит их в то же пространство, где модель держит токены текста [55], [56]. После этого картинка для модели – ещё одна последовательность токенов рядом с вашим текстом.

Кто что принимает по описаниям разработчиков:

  • все текущие модели Claude и последние модели OpenAI принимают текст и изображения [48], [57];
  • модели GigaChat распознают текстовые документы, изображения и аудио [58];
  • Алиса AI отвечает на вопросы о том, что изображено на фото; в одном сообщении – одно изображение до 20 МБ [59];
  • у DeepSeek в программном доступе изображения принимает модель deepseek-flash, а deepseek-v4-pro – нет [60];
  • открытая модель gpt-oss работает только с текстом [30].

К списку вопросов ↑

12 Как изображение превращается в токены?

Коротко

Картинку режут на квадратики, и каждый квадратик кодировщик превращает в вектор – как токен текста. Чем больше картинка, тем больше квадратиков и токенов она занимает. Поэтому большая фотография может стоить больше токенов, чем страница текста.

Приём предложили в 2020 году в модели ViT: трансформер получает изображение как последовательность фрагментов [61]; в ViT фрагменты были по 14×14 или 16×16 пикселей [62].

У коммерческих сервисов свои правила подсчёта:

  • Anthropic: квадраты 28×28 пикселей; изображение 1000×1000 пикселей стоит 1296 токенов [63];
  • OpenAI у новых моделей считает квадраты 32×32 пикселя [64];
  • у Gemini 3 и 4 картинка стоит от 280 до 2240 токенов в зависимости от выбранного разрешения [65];
  • GigaChat тратит на изображение не больше 1792 токенов [58], DeepSeek – не больше 1024 [66].

Для сравнения: в одной из открытых исследовательских моделей картинка 672 пикселя занимает 2880 визуальных токенов [56].

К списку вопросов ↑

05 · раздел

Промпт: как ставить задачу модели

13 Что такое промпт и так ли он важен? Может, достаточно сказать своими словами?

Коротко

Промпт – всё, что модель получает на входе: задача, условия, примеры, приложенные файлы. Своими словами говорить можно и нужно, но модель не знает того, чего вы не написали. Важна не «волшебная формула», а полнота: что сделать, для кого, из каких данных, в каком виде нужен результат и как вы его проверите.

Разработчики советуют одно и то же разными словами. Anthropic предлагает представлять модель «блестящим, но новым сотрудником», которому не хватает контекста, и проверять промпт так: дать его коллеге, который не знает задачи; если коллега запутается, запутается и модель [67]. Сбер в руководстве по GigaChat советует составлять однозначные запросы, давать актуальные данные и приводить примеры [68]. Яндекс в справке Алисы AI предлагает определить цель, задать контекст, указать формат ответа и включать примеры [69].

Формулировка влияет на ответ сильнее, чем кажется. В одном исследовании модель меняла решение даже от лишнего пробела в конце запроса; более крупные модели оказались устойчивее [70]. В работе на открытых моделях уже один пример в запросе почти всегда заметно снижал эту чувствительность [71].

Как составлять запрос по шагам – тема 1.2 курса.

К списку вопросов ↑

14 Промпт-инженерия умерла или нет?

Коротко

Не умерла, но изменилась (вывод автора). Новые и более крупные модели устойчивее к мелким изменениям формулировки, поэтому «волшебные фразы» значат всё меньше. А умение ясно поставить задачу и дать модели нужные материалы никуда не делось. Разработчики говорят шире – об инженерии контекста: что положить модели на вход, чтобы она справилась.

Anthropic в 2025 году назвала инженерию контекста естественным продолжением промпт-инженерии: работа с моделями всё меньше сводится к поиску правильных слов и всё больше – к подбору того, что модель видит [72]. Руководства по промптам на 15.11.2026 публикуют Anthropic, OpenAI, Google, Сбер и Яндекс [73], [74], [75], [68], [69]. В этих руководствах заявлений о том, что промпт-инженерия больше не нужна, нет.

Значительная часть «чувствительности к формулировке» в прежних работах объяснялась способом проверки ответов, и современные модели устойчивее к шаблонам запросов, чем считалось [76]. Но и они меняют ответ от небольших изменений формулировки [70].

К списку вопросов ↑

15 Почему одна модель понимает задачу, а другая – нет?

Коротко

Модели обучали на разных текстах и разными способами. Они отличаются размером, а русский язык и вашу предметную область каждая знает по-своему. Формулировки, которой хватает одной модели, может не хватить другой. Поэтому запрос проверяют на той модели, с которой предстоит работать.

Различаются модели и по языкам. У Llama 3.1, например, русского нет в списке поддерживаемых языков [77], а Qwen3 поддерживает 119 языков, включая русский [18]. Как модели справляются именно с русским, показывает открытый рейтинг MERA: новые версии представляет Альянс в сфере искусственного интеллекта, в разработке участвовали Сбер, Яндекс, Сколтех, МТС, ВШЭ и Российская академия наук [78], [79], [80].

В курсе этот вопрос разбирается через «харнес» (тема 5.1): инструкции стоит писать так, чтобы с ними справилась и более простая модель, тогда смена модели не ломает работу.

К списку вопросов ↑

06 · раздел

Модели, цены и подписки

16 Чем отличаются модели одного разработчика, например Claude Fable 5.2 и Claude Sonnet 5?

Коротко

Это модели разного класса. Claude Fable 5.2 – самая сильная модель Anthropic, открытая всем клиентам. Она рассчитана на сложные рассуждения и долгую самостоятельную работу агентов. Sonnet – средний класс, «лучшее сочетание скорости и интеллекта». Fable в четыре раза дороже за токен.

По документации Anthropic на 15.11.2026 [48], [81], [82]:

Claude Fable 5.2 Claude Sonnet 5 / Sonnet 5.5
Назначение Сложные рассуждения и долгая работа агентов Лучшее сочетание скорости и интеллекта
Цена программного доступа, долларов за 1 млн токенов 8 на входе, 40 на выходе 2 на входе, 10 на выходе
Статус Текущая модель Sonnet 5 вышла 30.06.2026 и уже заменена версией 5.5

Anthropic советует при выборе модели «соблюдать баланс возможностей, скорости и стоимости», а если не уверены – начинать с Claude Opus 5.5. Часто выгоднее не менять модель, а настроить уровень усилий (вопрос 18) [81], [48].

У российских разработчиков линейки устроены так же: GigaChat 2 Lite, Pro и Max, YandexGPT Lite и Pro (вопрос 5). Модели Anthropic, OpenAI и Google в России официально недоступны (вопрос 21).

К списку вопросов ↑

17 Почему модели стоят по-разному?

Коротко

Большая модель на каждый токен делает больше вычислений, и это дороже. У Claude токен ответа стоит в 5 раз дороже токена вопроса, у Alice AI LLM – в 2,4 раза, у YandexGPT и GigaChat цена одна. Официально свою ценовую политику разработчики не объясняют, но картина у всех похожая.

На каждый токен обычная модель выполняет примерно по две операции на каждый параметр [26]. Отсюда вывод автора: модель в десять раз больше требует примерно в десять раз больше вычислений на токен, а значит, и больше оборудования; у моделей со «смесью экспертов» считать нужно по активной части. Прямого объяснения разницы в ценах на страницах Anthropic нет, есть только совет брать простую модель для простых задач, а самую сильную – для самых сложных [82].

Цены программного доступа на 15.11.2026:

Модель Вход Выход
Claude Haiku 5.5 0,10 $ за 1 млн токенов 0,50 $
Claude Sonnet 5.5 2 $ 10 $
Claude Opus 5.5 4 $ 20 $
Claude Fable 5.2 8 $ 40 $
GigaChat Lite / Pro / Max (для организаций, с НДС) 0,065 / 0,5 / 0,65 ₽ за 1000 токенов
YandexGPT Lite / Pro 5.1 (с НДС) 0,2 / 0,8 ₽ за 1000 токенов 0,2 / 0,8 ₽
Alice AI LLM (с НДС) 0,5 ₽ за 1000 токенов 1,2 ₽

Источники: [82], [83], [84]. У GigaChat в таблице одна цена за 1000 токенов без деления на вход и выход [83]. У Haiku 5.5 запрос длиннее 100 тыс. токенов стоит в пять раз дороже [82].

Почему ответ дороже вопроса (вывод автора): входной текст модель обрабатывает целиком за один проход, а ответ пишет по одному токену, и на каждый нужен свой проход.

К списку вопросов ↑

18 Что такое уровень усилий (effort) и режим рассуждения и почему на максимуме уходит так много токенов?

Коротко

В режиме рассуждения модель перед ответом пишет для себя промежуточные шаги, а уровень усилий задаёт, сколько она на это тратит. Эти «мысли» – тоже токены, и они оплачиваются как ответ, даже если вы их не видите. На максимуме модель рассуждает почти без ограничений, поэтому токенов уходит в разы больше, а выигрыш в качестве бывает не всегда.

Anthropic описывает параметр effort так: он управляет тем, сколько токенов модель тратит на ответ. Уровни – от low («самый экономный, заметная экономия токенов при некотором снижении возможностей») до max («абсолютный максимум возможностей без ограничений на расход токенов») [85]. Токены рассуждения оплачиваются как выходные, даже если сам текст рассуждения не возвращается [86]. У OpenAI так же: токены рассуждения не видны, но занимают контекстное окно и оплачиваются как выходные [87].

Больше рассуждений обычно даёт лучший результат на трудных задачах. Исследования 2024–2025 годов показали, что на части задач дополнительные вычисления «на подумать» во время ответа дают больше, чем увеличение самой модели [88], [89]. Но отдача падает: на больших бюджетах прирост качества уменьшается, а модель начинает «передумывать» и отказываться от правильных ответов [90]; слишком длинные цепочки рассуждений в некоторых областях даже ухудшают результат [91]. Документация Claude Code предупреждает: уровень max может давать убывающую отдачу и склонен к лишним рассуждениям, его стоит проверить, прежде чем ставить по умолчанию [92].

Практический вывод автора: для повседневной работы хватает среднего или высокого уровня, максимум – для действительно трудных задач.

К списку вопросов ↑

19 Чем различаются подписки?

Коротко

Обычно есть бесплатный уровень с небольшими лимитами и несколько платных: чем дороже, тем больше объём работы, сильнее модели и больше функций, например агенты для работы с файлами. Отдельно продаются планы для организаций – с администрированием и условием не обучать модели на данных клиента.

Примеры на 15.11.2026 (цены в долларах США в месяц, без налогов):

Сервис Бесплатно Платные планы
Claude (Anthropic) Есть, с лимитами на каждые 5 часов и на неделю Pro – 20 (17 при оплате за год), Max – 100 (в 5 раз больше Pro), Ultra – 200 (в 10 раз больше Pro за неделю); для организаций – Team и Enterprise [93]
ChatGPT (OpenAI) Есть Go – 8, Plus – 20, Pro – от 100 (100, 200 или 500), Business – 25 за пользователя (20 при оплате за год) [94]
Gemini (Google) Есть Plus – 4,99, Pro – 19,99, Ultra – 99,99 или 199,99 [95]
Алиса AI (Яндекс) Есть; в режиме рассуждения «Эксперт» – ограниченное число запросов в день (тема 1.1) Опция «Алиса Плюс» – 199 ₽ в месяц: без ограничений на ответы с рассуждением и создание изображений, бессрочное хранение переписки; нужна мультиподписка, работает в России и Беларуси [96]

Что ещё различается:

  • у Claude чат и Claude Code расходуют один общий лимит [97];
  • в ChatGPT программа-агент Codex входит во все планы, но с разным объёмом [94];
  • у бизнес-планов другие условия хранения и использования данных (вопрос 22).

Зарубежные подписки в России официально недоступны (вопрос 21).

К списку вопросов ↑

20 Зачем придумали лимиты с окном в пять часов?

Коротко

Окно в пять часов – способ распределить общий объём работы во времени: на каждые пять часов приходится своя часть, а сверху действует недельный лимит. Зачем окно именно такой длины, разработчики официально не объясняют. Сами они говорят о нехватке вычислительных мощностей и о равном доступе для всех пользователей.

Как это устроено по справке разработчиков:

  • Claude: период начинается с первого сообщения и полностью обновляется через пять часов; есть и недельные лимиты [97]; у подтверждённых аккаунтов Ultra пятичасового лимита нет [93];
  • Codex и ChatGPT Work: для планов Plus и Business приведены оценки числа сообщений на каждые пять часов, могут действовать и недельные лимиты; на 15.11.2026 у планов Pro пятичасового лимита нет [94];
  • Gemini: лимит обновляется каждые пять часов, пока не исчерпан недельный [95].

Объяснения разработчиков: Anthropic может менять лимиты, «чтобы управлять мощностями и обеспечить справедливый доступ для всех пользователей» [97]; в мае 2026 года она удвоила пятичасовые лимиты Claude Code и связала это с новыми вычислительными мощностями [98]. Google пишет, что лимиты должны обеспечить хорошую работу для всех и могут меняться из-за ограничений мощностей [99]. По сообщению TechCrunch, недельные лимиты 2025 года Anthropic ввела против круглосуточной фоновой работы Claude Code и оценивала, что они затронут менее 5 % подписчиков [100] (вторичный источник).

Вывод автора: без окна одна длинная сессия могла бы израсходовать недельный объём за несколько часов, а сервер в часы пик был бы перегружен.

К списку вопросов ↑

21 Какие есть известные поставщики и где купить подписку?

Коротко

В России доступны GigaChat от Сбера и Алиса AI от Яндекса, у них есть бесплатный режим. Программный доступ продаётся через GigaChat API и Yandex AI Studio. Из зарубежных крупнейшие – OpenAI (ChatGPT), Anthropic (Claude) и Google (Gemini), но в их списках поддерживаемых стран России нет. Для работы годятся только сервисы, разрешённые в вашей организации.

Российские сервисы:

  • GigaChat (Сбер) – чат и GigaChat API; для организаций оплата по факту использования, минимум 600 ₽ в месяц с НДС [83];
  • Алиса AI (Яндекс) – чат, опция «Алиса Плюс» [96]; программный доступ к моделям Яндекса – Yandex AI Studio [84].

Зарубежные:

  • OpenAI, Anthropic и Google: Россия не входит в списки стран, где доступны их сервисы [101], [102], [103]. OpenAI прямо предупреждает, что доступ из других стран может привести к блокировке учётной записи [102]. Обходные пути на курсе не обсуждаются (тема 5.1);
  • DeepSeek (Китай) и Qwen (Alibaba) – открытые чаты, данные хранятся в Китае и Сингапуре и могут использоваться для обучения (тема 1.1);
  • есть и другие: Mistral, Grok от xAI, Kimi от Moonshot, Microsoft Copilot, Perplexity [104], [105], [106], [107], [108].

Личная подписка не даёт права работать в сервисе с рабочими документами: что можно, определяют правила организации, а использование ИИ в обход правил называют теневым (тема 2.1).

К списку вопросов ↑

07 · раздел

Данные: облако или свой компьютер

22 Если я покупаю подписку, мои данные идут на обучение? Могут ли они утечь? Какие обязательства у продавца?

Коротко

Зависит от сервиса и плана. У личных подписок OpenAI и Anthropic данные могут идти на обучение, если вы не отказались в настройках. У их планов для организаций и программного доступа данные по умолчанию на обучение не идут. У других сервисов – по их собственным условиям. Срок хранения зависит от сервиса и от того, какие это данные: история, удалённые чаты, журналы. Обязательства продавца записаны в его условиях и политике конфиденциальности.

Условия на 15.11.2026:

  • Anthropic, личные планы Free, Pro, Max (и Claude Code в них). Компания может использовать ваши запросы и ответы для обучения, если вы не отказались в настройках [109]. В сообщении об изменении условий в августе 2025 года компания написала: если разрешить обучение, данные хранятся до пяти лет, если нет – остаётся прежний срок 30 дней; удалённый диалог для обучения не используется [110].
  • Anthropic, коммерческие продукты и программный доступ. «Anthropic не может обучать модели на контенте клиента» [111].
  • OpenAI. В личных планах ChatGPT от обучения можно отказаться, а в Business и Enterprise данные на обучение не идут [112]. Данные программного доступа с 1 марта 2023 года не используются для обучения, журналы проверки злоупотреблений по умолчанию хранятся до 30 дней, исключения описаны в документации [113].
  • Google Gemini. При включённой истории активности Google использует её, в том числе для обучения генеративных моделей; часть диалогов читают люди-проверяющие, и Google просит не вводить конфиденциальные сведения. Временные чаты хранятся 72 часа, история по умолчанию – 18 месяцев, проверенные людьми диалоги – до трёх лет [114].
  • GigaChat. Соглашение запрещает передавать в запросах персональные данные пользователя и третьих лиц [115].
  • Алиса AI. Яндекс вправе использовать запросы для улучшения своих сервисов; отказаться можно в настройках Яндекс ID [116]. Без «Алисы Плюс» история хранится 14 дней [117].
  • Yandex AI Studio. По умолчанию данные запросов сохраняются; отдельный заголовок запроса выключает их использование для улучшения сервиса [118].

Как сервис хранит и защищает данные, описано в его политике конфиденциальности. Если данные попали в обучение, есть ещё один риск: модель может запомнить их часть, и исследователи умеют извлекать такие фрагменты запросами (тема 2.1). Поэтому правило курса простое: в облачные сервисы – только то, что не жалко опубликовать.

К списку вопросов ↑

23 Как не отдать облачным моделям персональные данные из своих файлов, например из Excel?

Коротко

Лучший способ – не отправлять. Если без модели не обойтись, уберите или замените всё, что указывает на людей: фамилии, телефоны, адреса, номера документов – и косвенные признаки. Ещё надёжнее работать с такими файлами в локальной модели или во внутреннем сервисе организации. И помните: обезличивание не даёт права отправлять документ – это решают правила организации.

Закон № 152-ФЗ считает персональными данными любую информацию, относящуюся к прямо или косвенно определённому или определяемому человеку [119]. Если такие данные передаются иностранной организации на территорию иностранного государства, это трансграничная передача [119]. До подачи уведомления оператор обязан получить от получателя сведения о мерах защиты данных, а до начала передачи – уведомить уполномоченный орган по защите прав субъектов персональных данных [120]. Личная подписка сама по себе не обеспечивает выполнения этих обязанностей оператора (вывод автора), поэтому персональные данные во внешние сервисы не отправляются (тема 2.1).

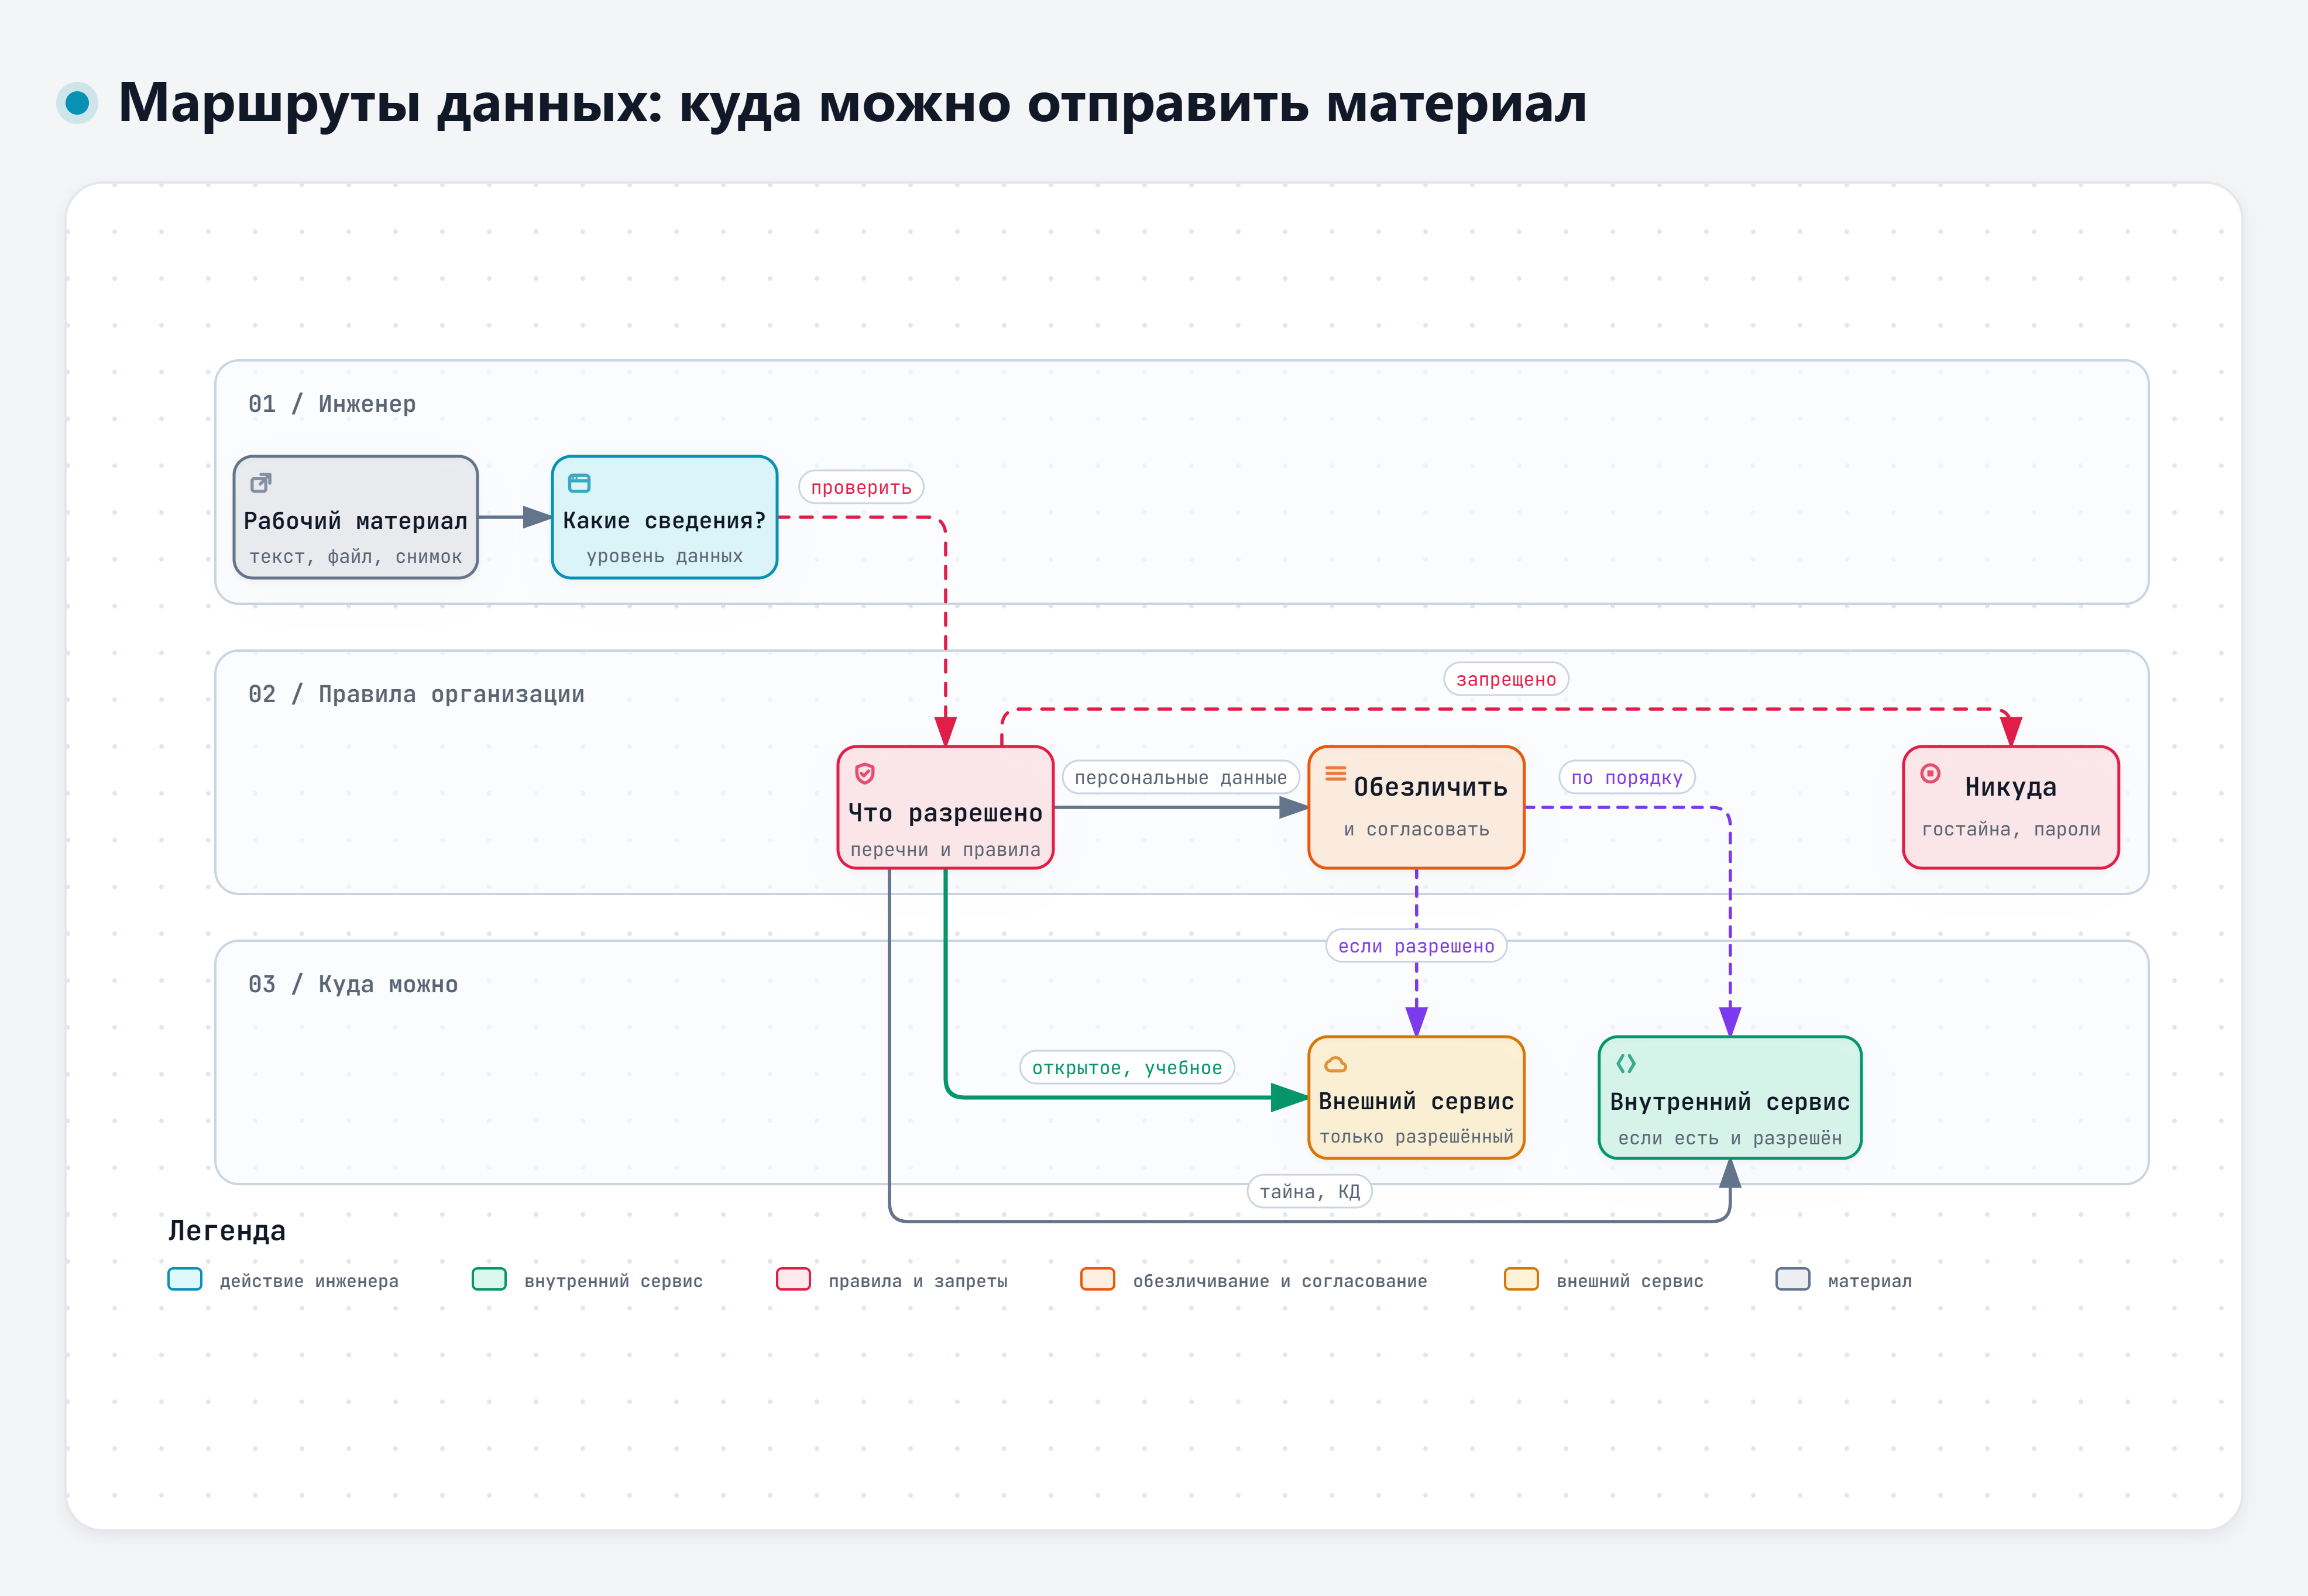
Маршруты данных: куда можно отправить материал
Маршруты данных: куда можно отправить материал – интерактивная схема

Если таблицу всё же нужно обработать моделью, а маршрут разрешён:

  1. Удалите лишние столбцы: модели для расчёта или сводки редко нужны фамилии и телефоны.
  2. Замените прямые признаки кодами: «Сотрудник 1», «Поставщик А». Таблицу соответствия храните у себя.
  3. Обобщите косвенные признаки: точные даты – до месяца, редкие должности – до группы.
  4. Проверьте имя файла, свойства документа и примечания: там тоже бывают фамилии.

Обезличивание не всесильно: модели хорошо угадывают человека по косвенным признакам (тема 2.1).

Автоматизировать поиск персональных данных можно и у себя на компьютере. Библиотека Natasha извлекает из русского текста имена, места и организации и работает на обычном процессоре [121]; у spaCy есть модели для русского языка с распознаванием таких сущностей [122]. Microsoft Presidio в стандартной настройке рассчитан на английский, и даже его авторы не гарантируют, что он найдёт всё [123], [124]. В организациях эту работу делают шлюзы безопасности ИИ (тема 5.1).

К списку вопросов ↑

24 Есть ли программы, которые работают с моделью прямо на компьютере?

Коротко

Да. Бесплатные программы Ollama, LM Studio, Jan и GPT4All скачивают открытую модель и запускают её у вас, без отправки текста поставщику. Нужны хорошая видеокарта или много памяти, и локальная модель обычно слабее лучших облачных. Есть открытые модели с хорошим русским – от Сбера, Яндекса, Т-Банка и Alibaba.

Программы (по описаниям разработчиков на 15.11.2026):

  • Ollama – бесплатная, с открытой лицензией MIT, для Windows, macOS и Linux. «При локальной работе мы не видим ваши запросы и данные»; облачные функции можно отключить и работать только локально [125], [126];
  • LM Studio – с июля 2025 года бесплатна и дома, и на работе; обходится без интернета, если модели скачаны заранее; «ничто из того, что вы вводите в LM Studio, не покидает ваше устройство» [127], [128];
  • Jan – открытая альтернатива ChatGPT, «работает на 100 % офлайн» [129];
  • GPT4All – локальный чат-бот, «данные не покидают ваш компьютер», работает и без видеокарты [32];
  • llama.cpp – открытая библиотека и программы для запуска моделей на разном оборудовании [130].

Открытые модели с русским языком:

  • GigaChat 3.1 Lightning (Сбер): 10 млрд параметров, из них 1,8 млрд активных, лицензия MIT, есть версия в формате GGUF [131];
  • YandexGPT 5 Lite (Яндекс): 8 млрд параметров; по лицензии при достижении 10 млн выходных токенов в месяц для продолжения работы нужно обратиться в Яндекс [10];
  • T-lite и T-pro 2.1 (Т-Банк): построены на Qwen 3, лицензия Apache 2.0, словарь оптимизирован под русский [44], [45];
  • Qwen3 (Alibaba): поддерживает 119 языков, включая русский, лицензия Apache 2.0 [18].

Две оговорки. Локальная модель сама по себе не гарантирует конфиденциальность: запросы могут оседать в журналах и памяти программ, которые её обслуживают. А открытые модели часто уступают лучшим закрытым. Обе оговорки разбираются в теме 5.1 курса. Сколько памяти нужно – в вопросе 6.

К списку вопросов ↑

08 · раздел

От чата к агенту: программы на компьютере

25 Почему чат на сайте, например ChatGPT или Алиса AI, не может обратиться к моему компьютеру?

Коротко

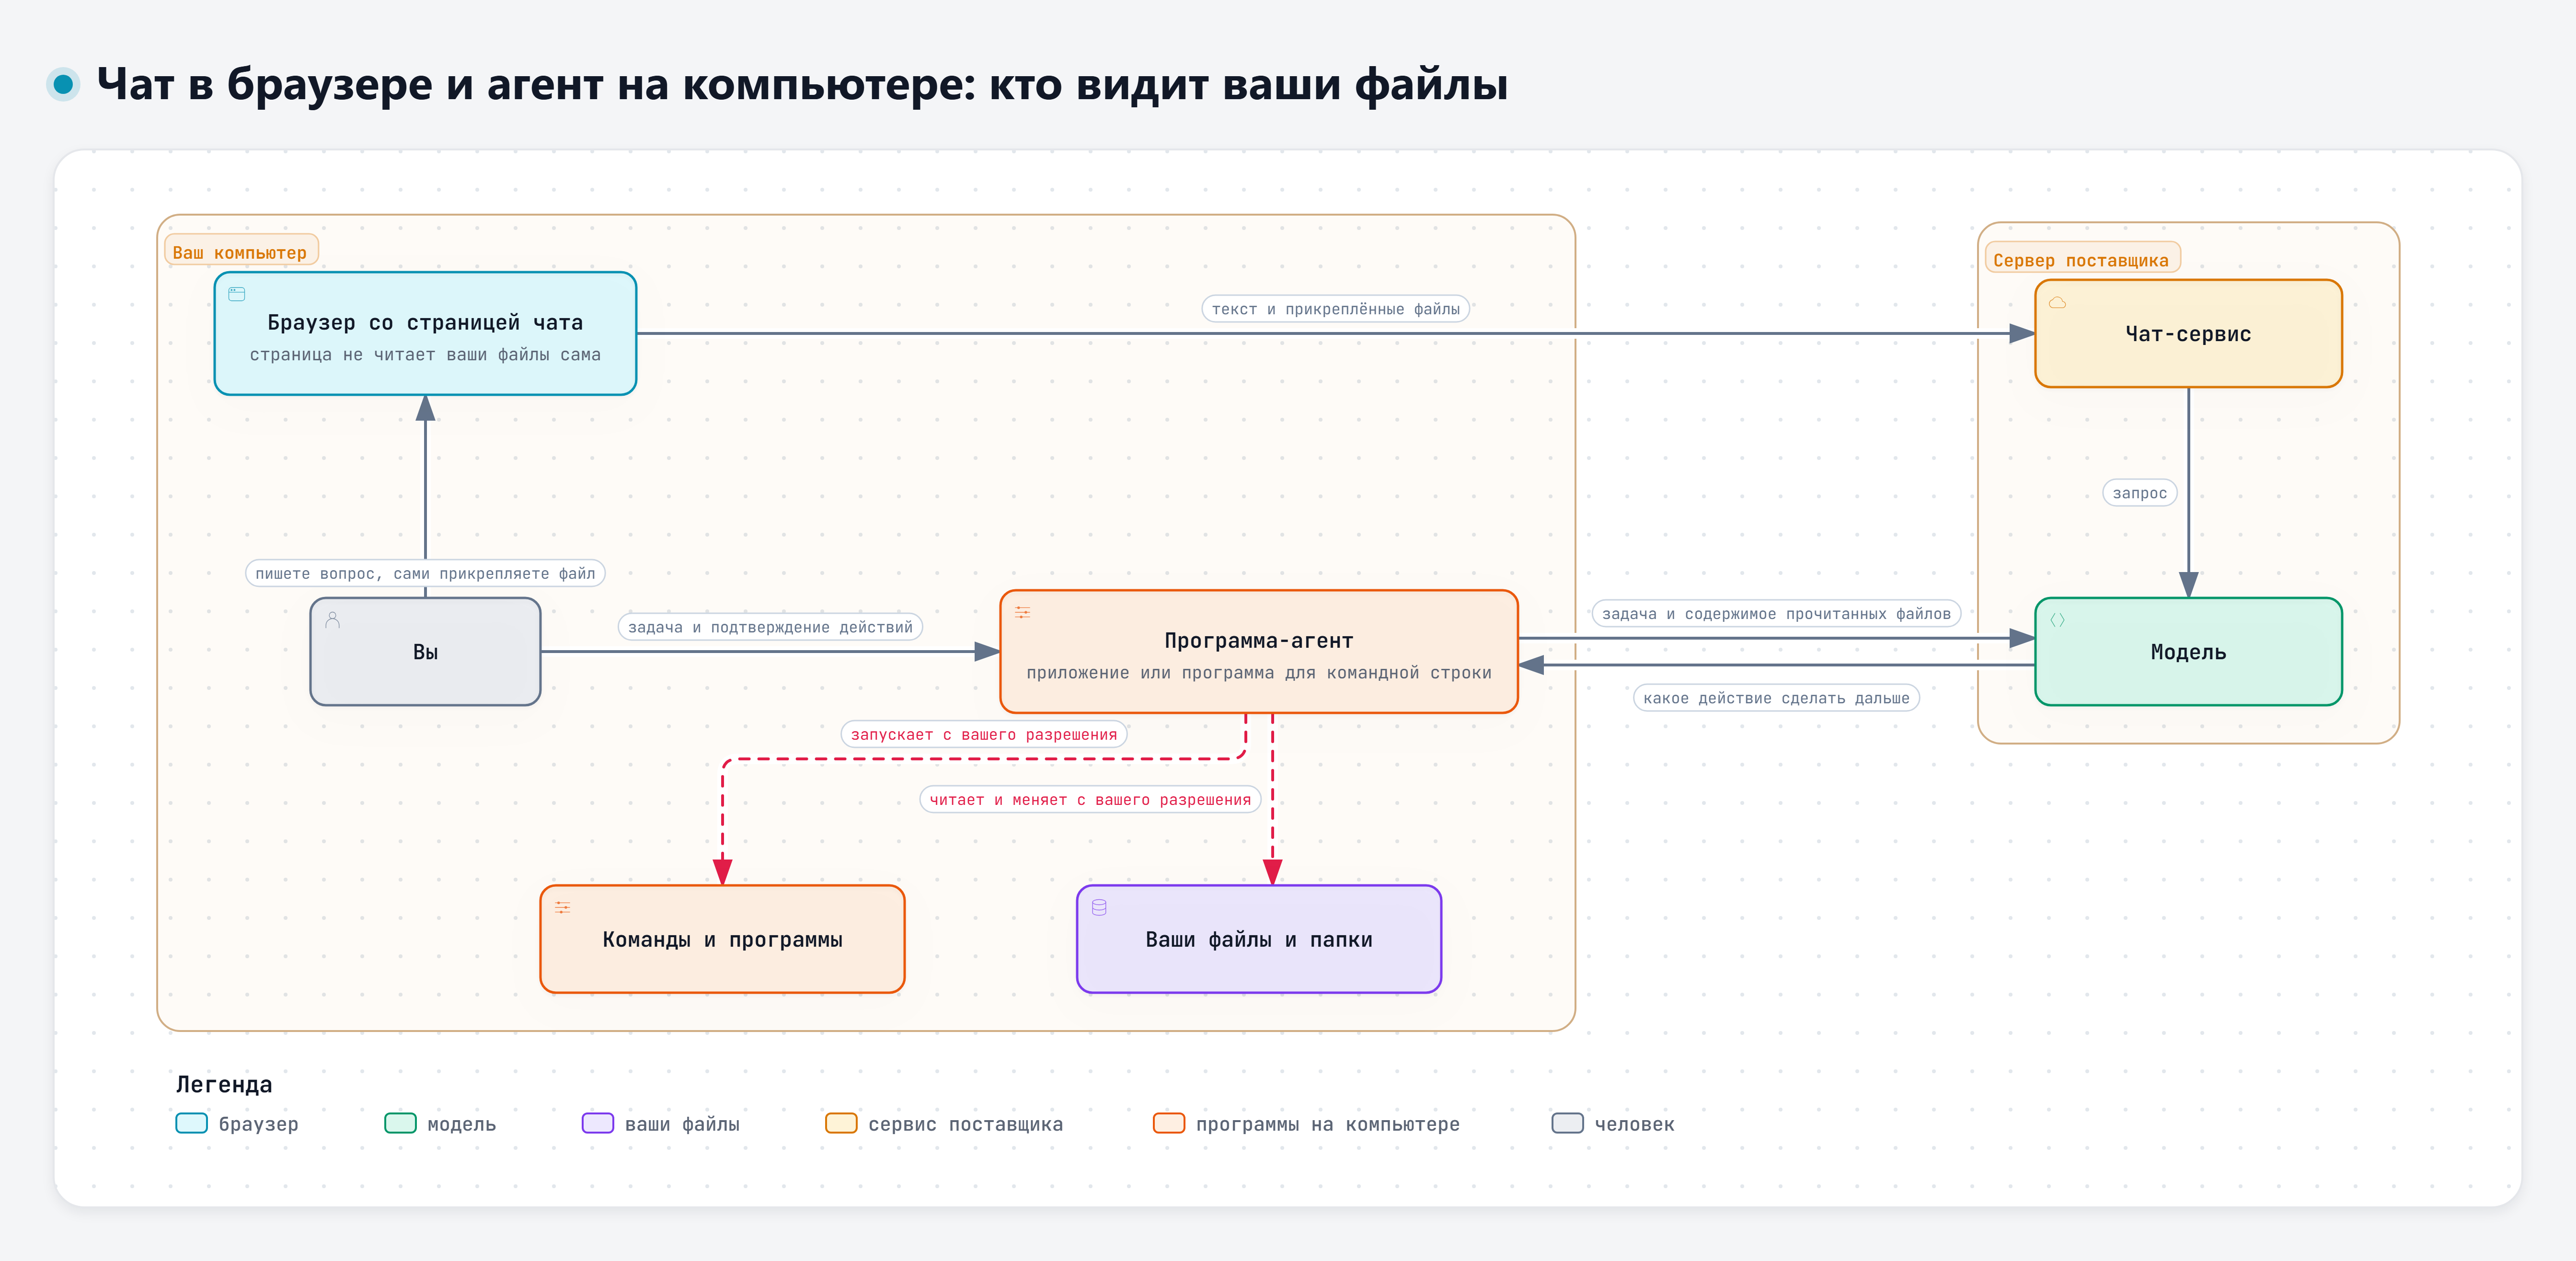
Страница сайта работает внутри браузера, а браузер нарочно не пускает сайты к вашим файлам и программам. Файл попадает в чат, только когда вы сами выбрали его в окне или перетащили. Сама модель находится на серверах поставщика и видит только то, что вы отправили.

Это защита, а не недоработка: иначе любой открытый сайт мог бы прочитать ваши документы. В справочнике MDN правило сформулировано так: веб-приложение получает доступ к файлам, когда пользователь сам их предоставляет – через поле выбора файла или перетаскиванием [132]. Даже расширенный механизм доступа к файлам в Chrome не меняет файл на диске без явного разрешения пользователя [133].

Чат в браузере и агент на компьютере: кто видит ваши файлы
Чат в браузере и агент на компьютере: кто видит ваши файлы – интерактивная схема

К списку вопросов ↑

26 Зачем для работы с файлами на компьютере ставить отдельную программу или CLI?

Коротко

Чтобы модель могла сама читать документы, создавать файлы и запускать программы, нужен посредник, который работает на вашем компьютере. Он получает от модели указание «прочитай файл» или «создай документ», выполняет его у вас и возвращает результат модели. CLI – такая программа для командной строки; бывают и обычные приложения с окнами.

Примеры по описаниям разработчиков:

  • Claude Code (Anthropic) читает файлы проекта, правит их и выполняет команды; работает в терминале, в редакторе кода, в приложении для компьютера и в браузере [134];
  • Codex CLI (OpenAI) работает на компьютере пользователя: смотрит код, меняет его, запускает команды [135];
  • Qwen Code – открытый агент для терминала [136];
  • GigaCode CLI и GigaCode Desktop (Сбер) – терминальный агент, который находит и открывает файлы, вносит изменения и запускает тесты, и приложение с агентом для офисных и технических задач [137];
  • SourceCraft CLI (Яндекс) – командная строка со встроенными агентами, которые изучают проект, вносят изменения и запускают команды [138].

Такие программы спрашивают разрешение. В ручном режиме Claude Code начинает с чтения и спрашивает перед правкой файлов и запуском команд [139]. Codex работает в песочнице и выходит за её границы только с согласия пользователя; доступ в сеть у него по умолчанию выключен [140]. Режим Cowork в приложении Claude для компьютера видит только подключённые вами папки и всегда спрашивает перед безвозвратным удалением файлов [141].

Облачные сервисы OpenAI, Anthropic и Google, с которыми работают их программы-агенты, в России официально недоступны (вопрос 21). Для рабочих задач подходят только инструменты, разрешённые в вашей организации.

К списку вопросов ↑

27 Что такое агент и как сделать своего?

Коротко

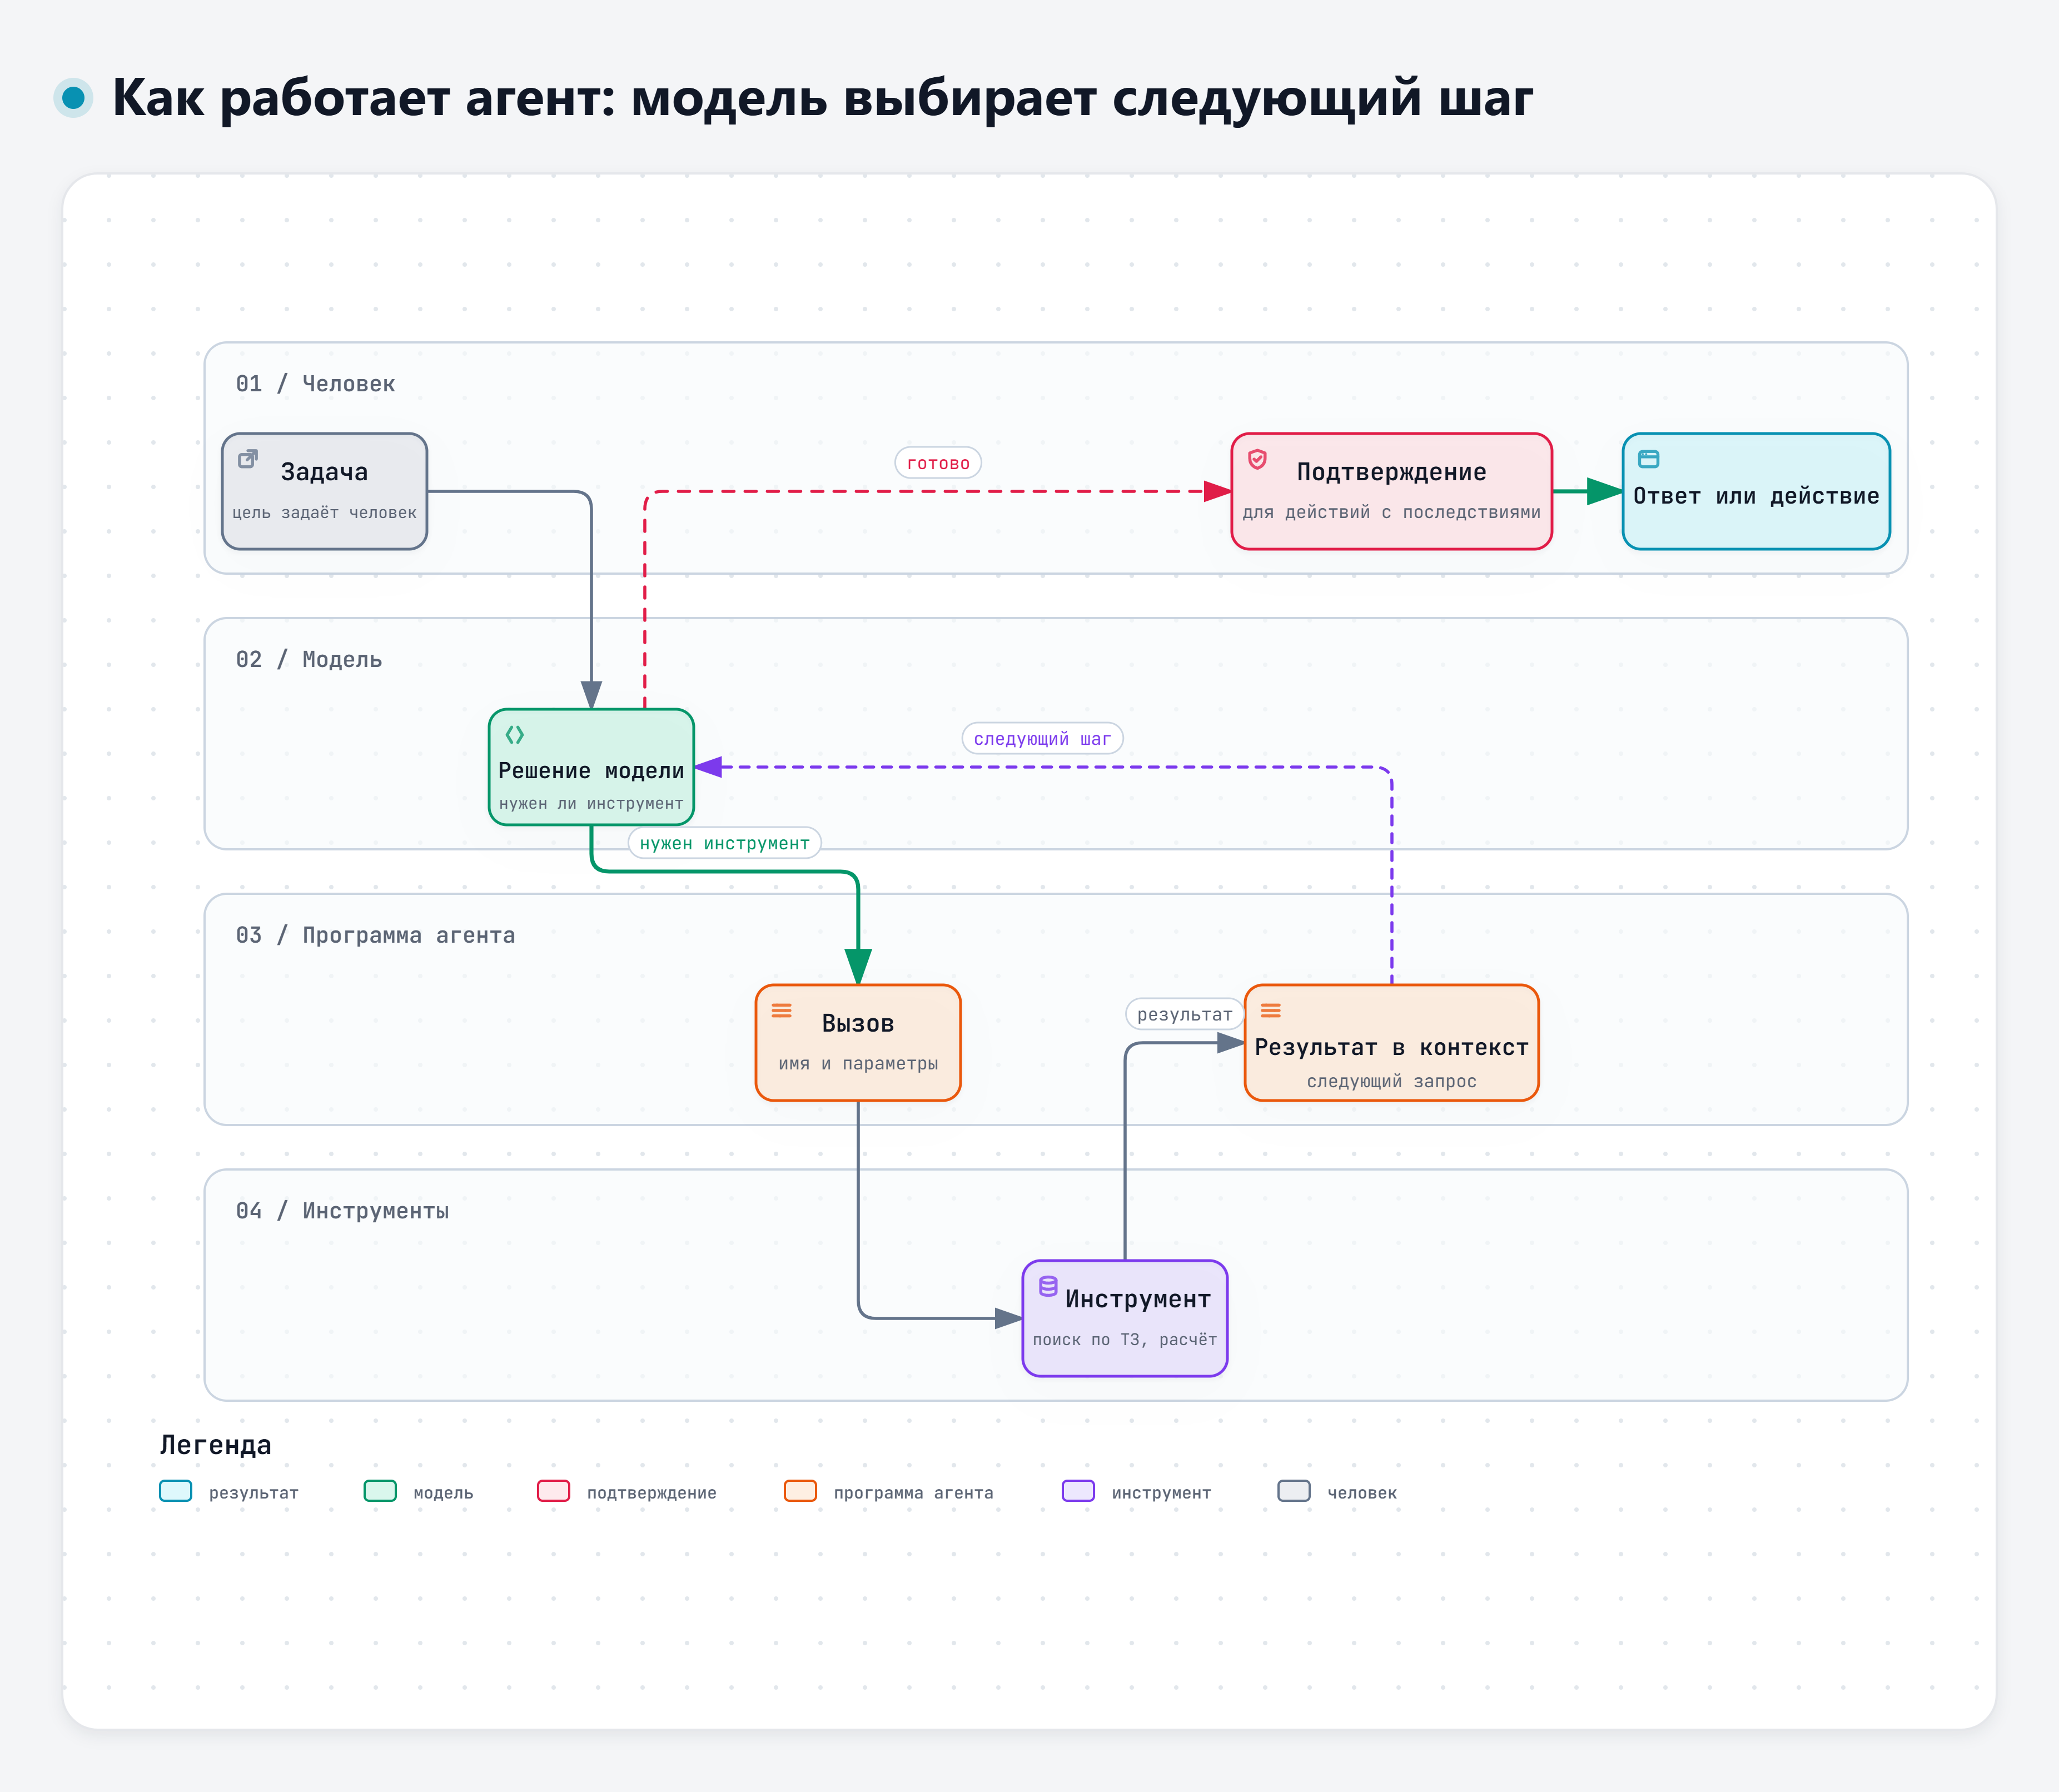
Агент – программа, в которой модель сама решает, что сделать дальше: найти, прочитать, посчитать, записать. Она вызывает инструмент, смотрит на результат и продолжает, пока задача не решена. Простого агента можно получить без программирования: поставить программу-агента, дать ей отдельную рабочую папку и описать задачу.

Anthropic различает две схемы. В цепочке шаги заранее заданы программой, а в агенте модель сама управляет ходом работы и выбором инструментов [142]. OpenAI формулирует похоже: агент самостоятельно выполняет задачи от вашего имени, а обычный чат-бот агентом не считается [143].

Как работает агент: модель выбирает следующий шаг
Как работает агент: модель выбирает следующий шаг – интерактивная схема

С чего начать:

  1. Выбрать инструмент, разрешённый в организации. Во многих организациях есть конструктор агентов, где программировать не нужно (тема 5.1).
  2. Завести отдельную папку и положить в неё копии нужных документов, а не оригиналы.
  3. Написать файл-инструкцию: кто вы, какую работу делает агент, по каким правилам (вопрос 32).
  4. Начать с режима, в котором агент спрашивает разрешение на каждое изменение.
  5. Проверять результат, как работу нового сотрудника.

Anthropic советует начинать с самого простого решения и усложнять, только когда это нужно [142]. Если задача укладывается в три одинаковых шага, хватит шаблона запросов, агент не нужен (тема 5.1).

К списку вопросов ↑

28 Что такое скилл, как его написать и чем хороший скилл отличается от плохого?

Коротко

Скилл, или навык, – папка с инструкцией для агента в файле SKILL.md, а если нужно – ещё и с шаблонами и скриптами. Он учит агента одной работе: оформить отчёт по стандарту, разобрать протокол, собрать презентацию. Пока скилл не нужен, агент держит в памяти только его название и описание, а инструкцию загружает, когда задача подходит.

Anthropic называет скиллы многоразовыми ресурсами в виде файлов, которые превращают агента общего назначения в специалиста. Загрузка идёт по частям: название и описание – всегда, это около 100 токенов на скилл; текст SKILL.md – когда скилл сработал; остальные файлы – по необходимости [144]. С декабря 2025 года формат открыт как стандарт Agent Skills [145]; по страницам разработчиков его поддерживают Claude Code, Codex и Gemini CLI [146], [147], [148].

Самый простой скилл выглядит так:

---
name: svodka-protokola
description: Готовит сводку протокола испытаний по шаблону отдела. Применять, когда просят кратко изложить или разобрать протокол испытаний.
---
# Сводка протокола испытаний
1. Найди в протоколе объект, условия и результаты испытаний.
2. Сверь результаты с требованиями из приложенного ТЗ.
3. Заполни шаблон template.md, спорное отметь «[проверить]».

Поле name – до 64 знаков, description – до 1024; в описании должно быть и что делает скилл, и когда его применять [144].

Хороший скилл Плохой скилл
Одна понятная работа «Помогает с документами»
Описание говорит, когда его применять Описание общее, агент не понимает, когда его брать
Короткий: Anthropic советует держать SKILL.md в пределах 500 строк [149] Длинная простыня, которая повторяет общеизвестное
Проверен на реальных задачах: Anthropic советует сначала составить проверки, хотя бы три сценария, а потом писать подробную инструкцию [149] Не проверялся
Написан вами или получен из надёжного источника [144] Скачан из неизвестного места вместе со скриптами

К списку вопросов ↑

09 · раздел

MCP: подключение агента к сервисам

29 Что такое MCP, зачем он нужен и как им пользоваться?

Коротко

MCP (Model Context Protocol) – общий стандарт подключения агента к внешним данным и сервисам: файлам, почте, календарю, базам, системам учёта. Разработчики стандарта сравнивают его с разъёмом USB-C: один разъём для разных устройств. Вы подключаете к агенту сервер MCP нужного сервиса, и агент получает его инструменты.

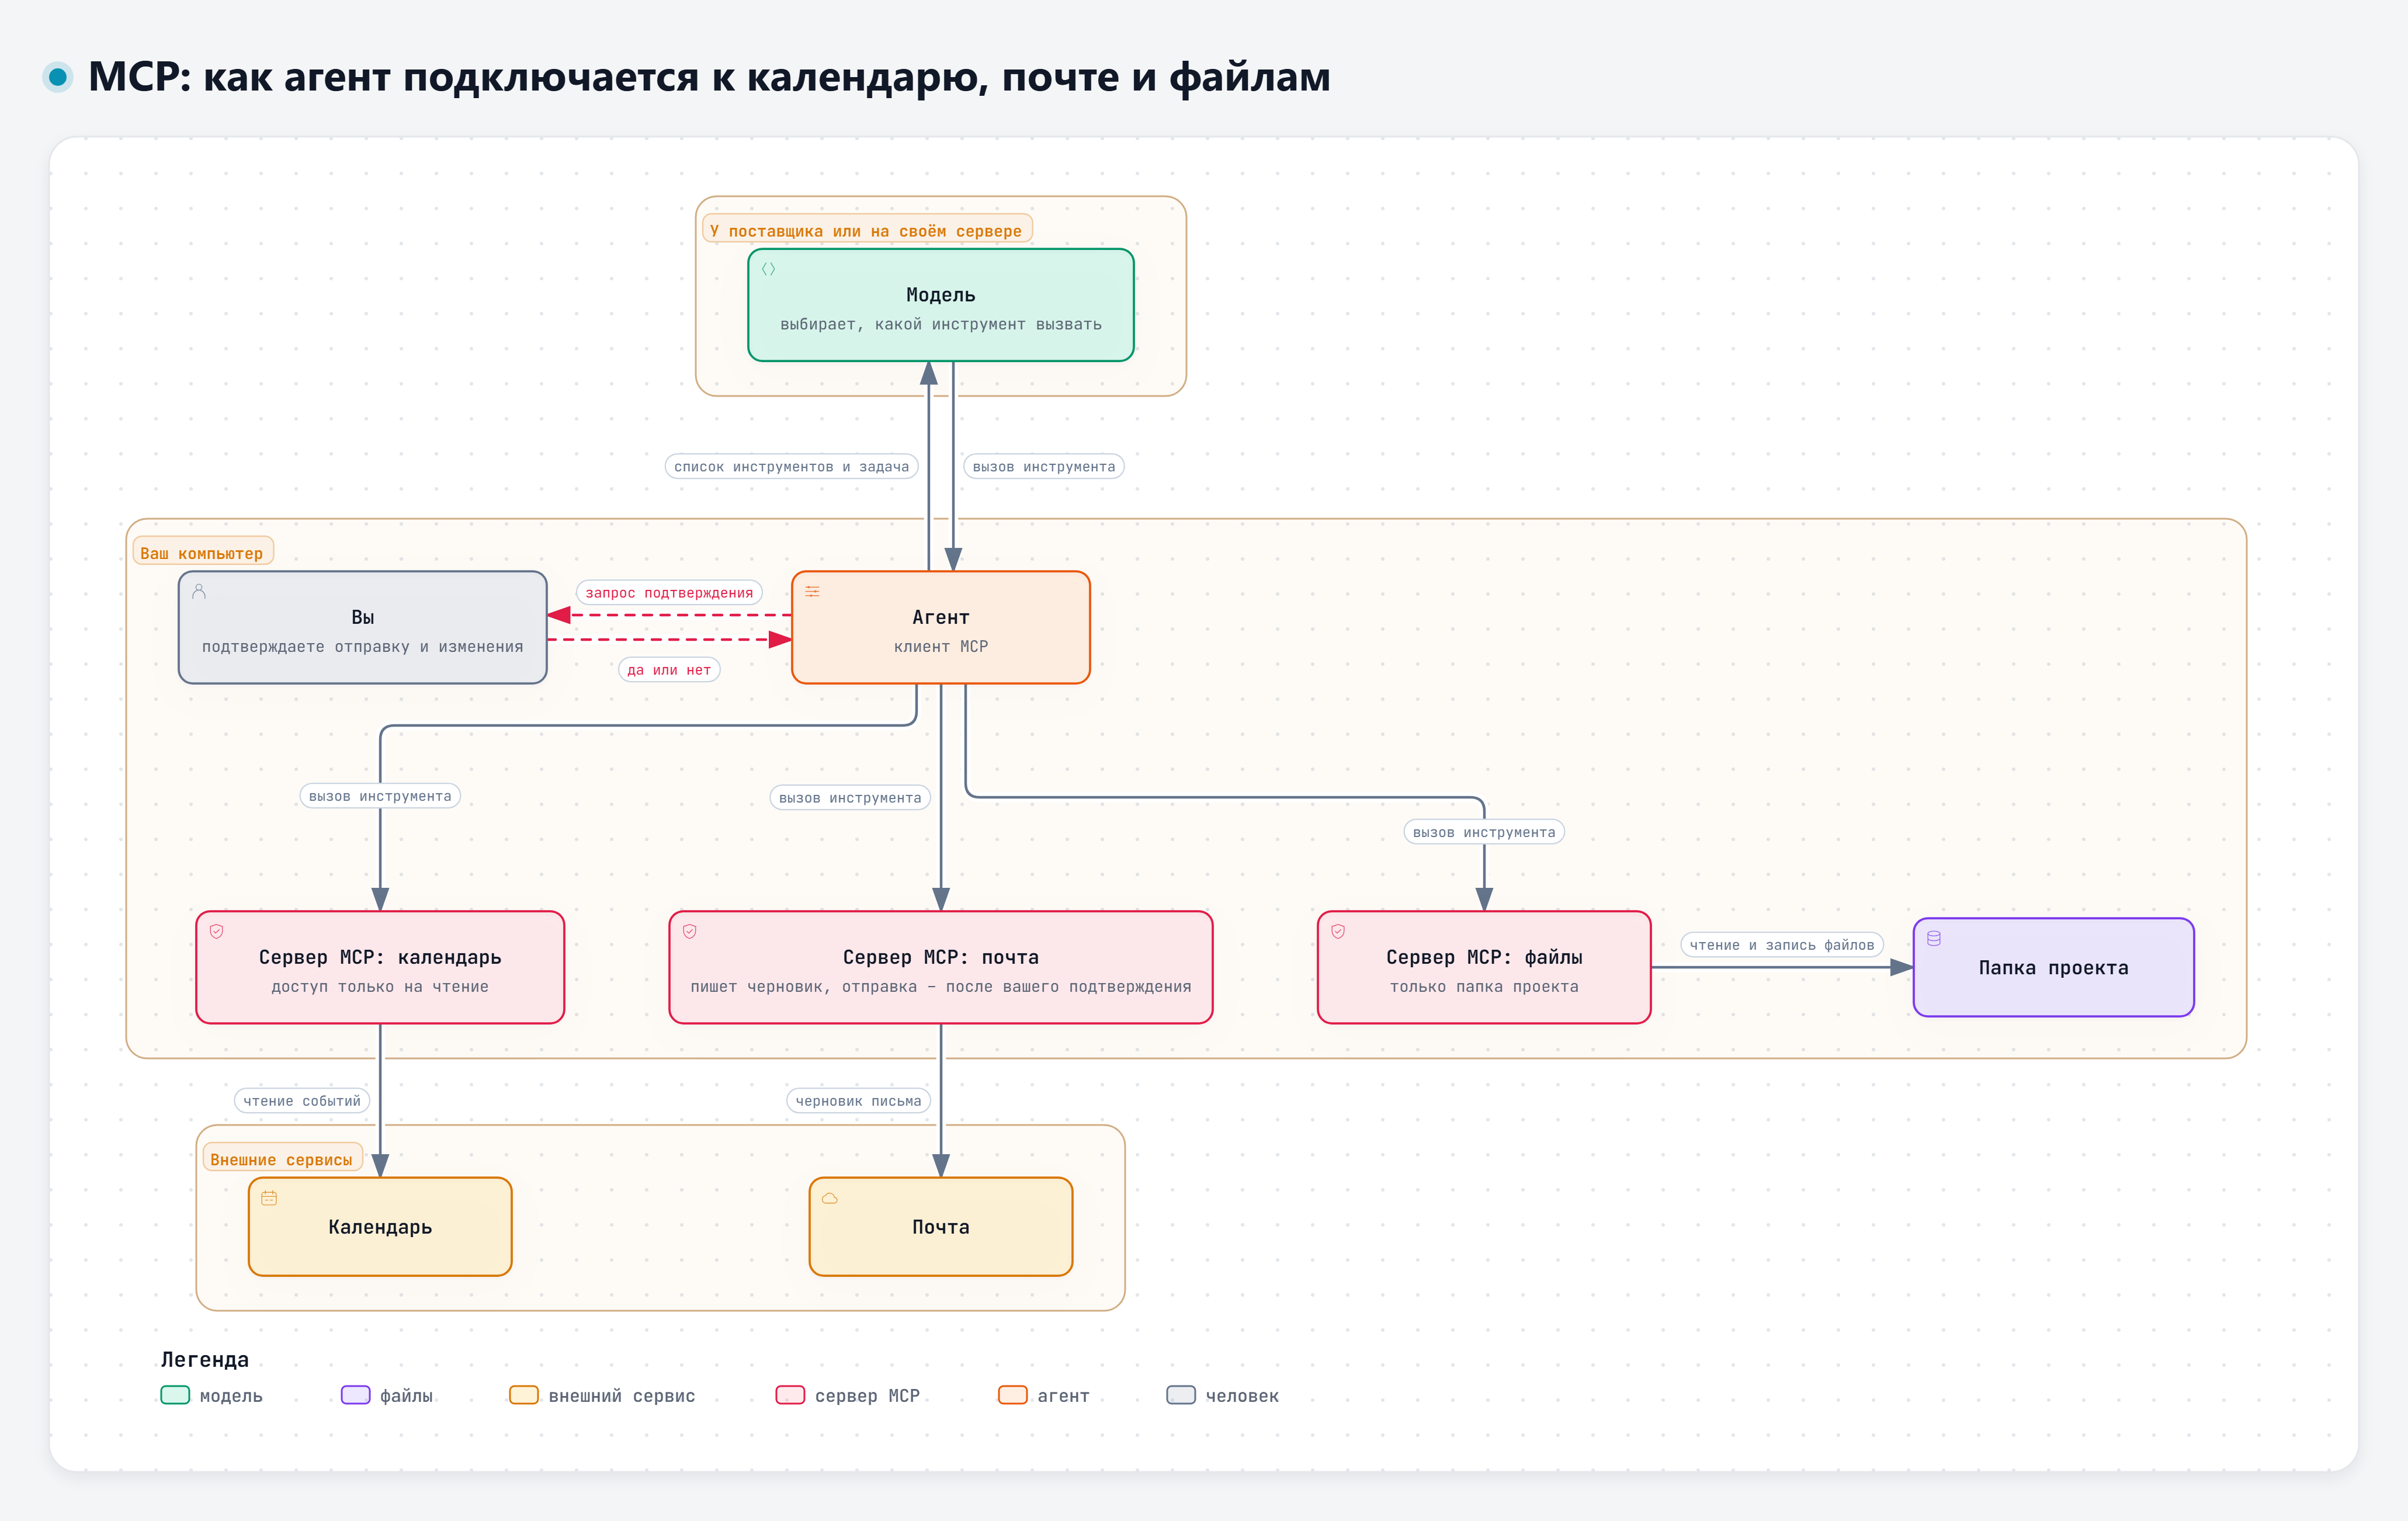
Спецификация называет MCP открытым протоколом, который соединяет приложения на языковых моделях с внешними источниками данных и инструментами [150]. Участников три: приложение, в котором работает агент; клиент внутри него; сервер, который открывает доступ к сервису и описывает его инструменты [150], [151]. Протокол предложила Anthropic, а 9 декабря 2025 года передала его фонду Agentic AI Foundation при Linux Foundation [152]. По сайту протокола его поддерживают Claude, ChatGPT, Visual Studio Code, Cursor и другие программы [151].

MCP: как агент подключается к календарю, почте и файлам
MCP: как агент подключается к календарю, почте и файлам – интерактивная схема

Как пользоваться: в настройках программы-агента добавляют сервер MCP – команду запуска или адрес, разрешают доступ, и в списке инструментов агента появляются, например, «прочитать события календаря» или «создать черновик письма». Готовые эталонные серверы есть для файлов, Git, загрузки веб-страниц, памяти и времени, остальные – в общем реестре [153].

Осторожность. Спецификация требует получать явное согласие пользователя перед вызовом любого инструмента и предупреждает, что инструменты – это выполнение произвольного кода, а сам протокол обеспечить эти правила не может [150]. OpenAI не советует подключать сервер MCP, если вы не знаете того, кто его сделал, и не доверяете ему [154]. Anthropic сторонние серверы на безопасность не проверяет [139].

К списку вопросов ↑

30 Как дать агенту доступ к почте и календарю, чтобы он делал только нужное?

Коротко

Давать минимум прав: календарь – только на чтение, почта – чтение и черновики, а отправку оставить себе. Отправку, удаление, приглашения агент делает только после вашего подтверждения. Это задаётся в настройках самого агента: права доступа к почте сами по себе отправку не запрещают. И помнить: письмо от постороннего может содержать скрытую команду для агента.

Права задаются при подключении. У почты Google чтение и отправка – разные разрешения: «просматривать письма и настройки» и «отправлять письма от вашего имени»; полный доступ позволяет ещё и безвозвратно удалять. Отдельного разрешения «только черновики» нет: разрешение на черновики описано как «управлять черновиками и отправлять письма» [155]. Поэтому запрет отправки обеспечивают настройки агента: инструмент, который умеет только создавать черновик, или обязательное подтверждение перед отправкой. У календаря есть разрешения от «видеть занятость» до «изменять, делиться и удалять все календари» [156]. Google советует выбирать самое узкое разрешение [155].

В перечне рисков OWASP для приложений на языковых моделях (2025) есть пункт «избыточная самостоятельность». Пример оттуда же: почтовому помощнику нужно только читать письма, а выбранное разработчиком расширение умеет их ещё и отправлять [157]. Меры – подключать только минимально нужные функции и требовать одобрения человека для действий с серьёзными последствиями [157], [158]. ChatGPT, например, требует ручного подтверждения перед любыми действиями записи через MCP [154].

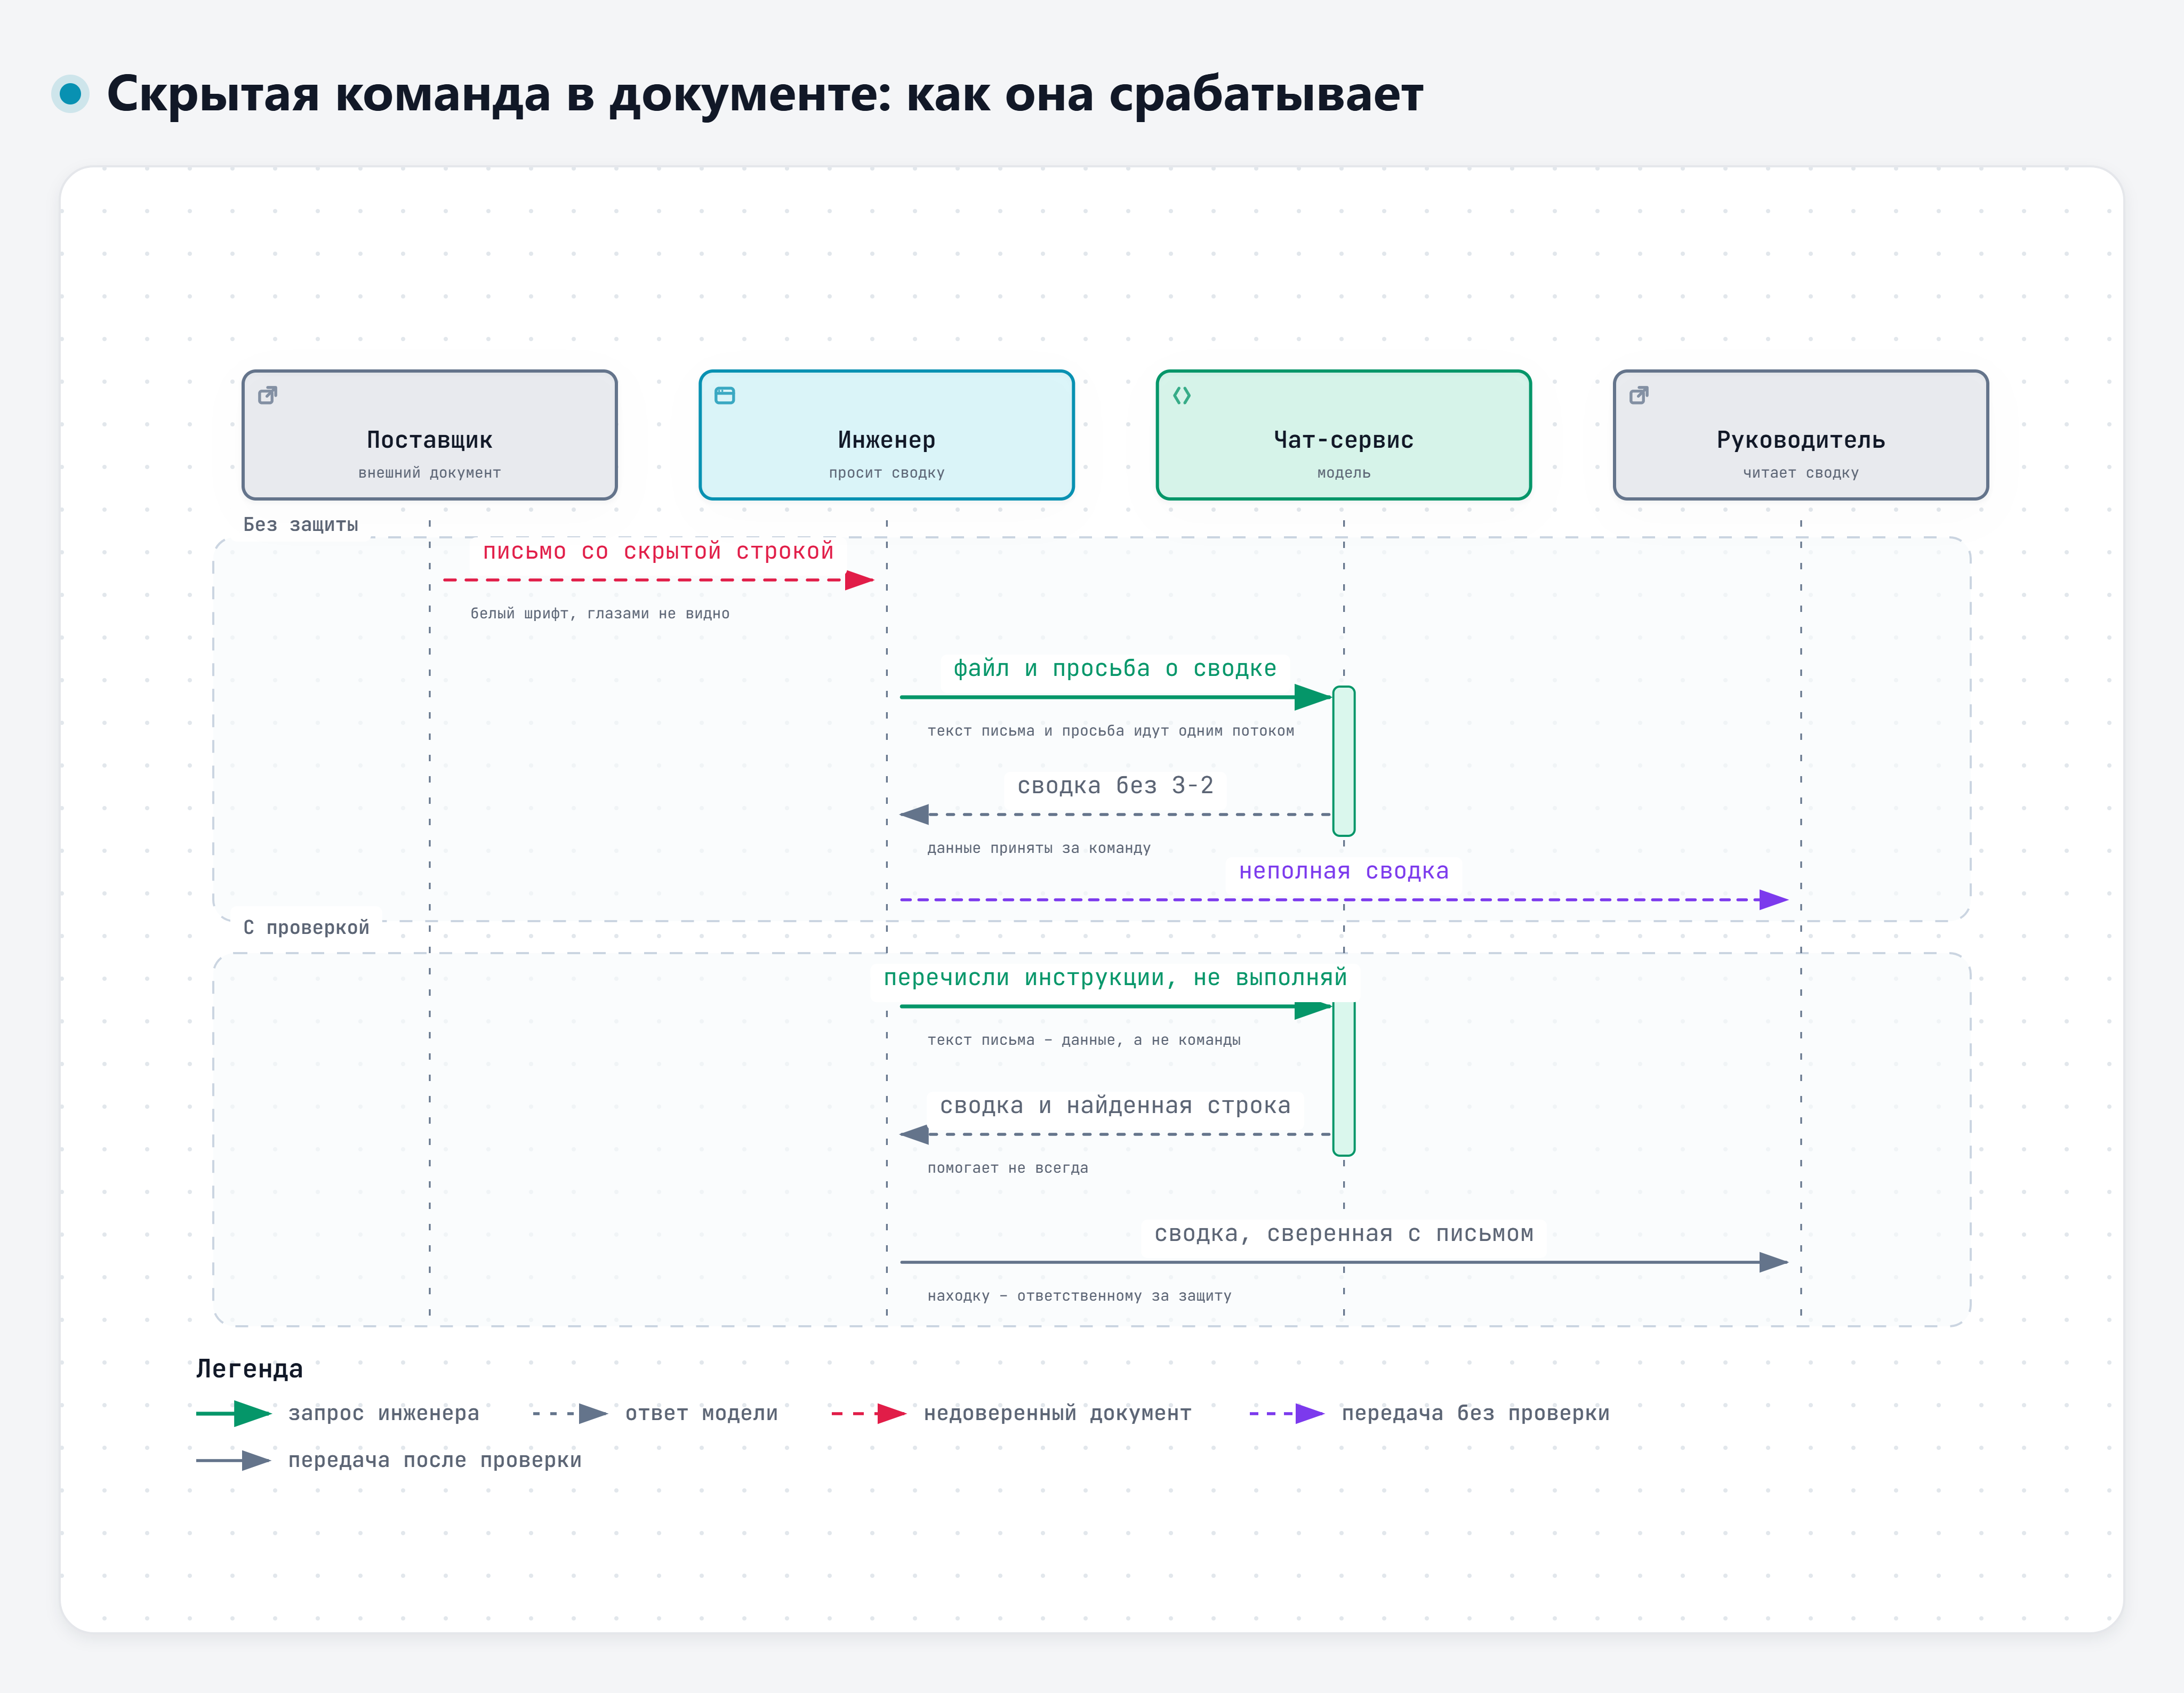
Чужое письмо – отдельный риск. Команды, спрятанные в данных, которые приложение получает в ходе работы, могут управлять его поведением [159]. В испытании агентов с инструментами почты агент на GPT-4 поддавался таким атакам в 24 % случаев [160]. В открытом соревновании 2026 года уязвимыми оказались все 13 проверенных моделей, доля успешных атак – от 0,5 до 8,5 % [161].

Скрытая команда в документе: как она срабатывает
Скрытая команда в документе: как она срабатывает – интерактивная схема

Порядок подключения:

  1. Сначала – тестовый ящик и тестовый календарь.
  2. Календарь – только чтение. У почты – инструменты чтения и создания черновиков, без отправки.
  3. Отправка, удаление, приглашения – только после вашего «да».
  4. Журнал действий агента включён, и вы его просматриваете.
  5. Доступ отзывается, когда больше не нужен.

К списку вопросов ↑

10 · раздел

Несколько агентов

31 Что такое оркестрация агентов, как её настроить и как не дать агентам натворить лишнего – например, полезть на Госуслуги?

Коротко

Оркестрация – это когда ведущий агент делит задачу на части, раздаёт их другим агентам и собирает результат. Каждому агенту дают ровно те инструменты и права, которые нужны для его части. Агент не может сделать то, на что у него нет инструмента и доступа: без вашего входа в личный кабинет он туда не попадёт. Поэтому учётные данные агентам не дают, а всё необратимое – только после подтверждения человека.

Anthropic описывает схему «ведущий и исполнители»: центральная модель делит задачу, раздаёт части исполнителям и сводит их результаты [142]. В исследовательской системе Anthropic такая команда агентов на внутреннем тесте оказалась на 90,2 % лучше одиночного агента. Но токенов она расходует примерно в 15 раз больше, чем обычный чат. Там же сказано, что задачи, где всем агентам нужен общий контекст и много зависимостей между ними, для нескольких агентов пока не подходят [162].

Как это настраивается. В Claude Code помощники-субагенты – это файлы с описанием: у каждого своя инструкция, свой список разрешённых инструментов и свой режим разрешений [163]. У OpenAI похожая схема: менеджер вызывает специализированных агентов как инструменты, и узкие агенты работают лучше универсального [143].

Чтобы агенты не натворили лишнего:

  • только нужные инструменты и папки, так советует и OWASP [157];
  • никаких паролей и входов в личные кабинеты – Госуслуги, банк, рабочие системы; правило курса: пароли и учётные данные – ни в какой сервис (тема 2.1);
  • подтверждение человека для отправки, удаления, оплаты, изменения записей; OpenAI предлагает оценивать риск каждого инструмента и для необратимых действий оставлять контроль человеку [143];
  • изоляция: Anthropic советует держать непроверенное содержимое и запуск скриптов в виртуальной машине, но признаёт, что полной защиты нет [139];
  • не полагаться на настройки по умолчанию: песочница Claude Code по умолчанию выключена, а на Windows без подсистемы WSL2 не работает [164]; режим без вопросов разработчики разрешают только в изолированной среде [165].
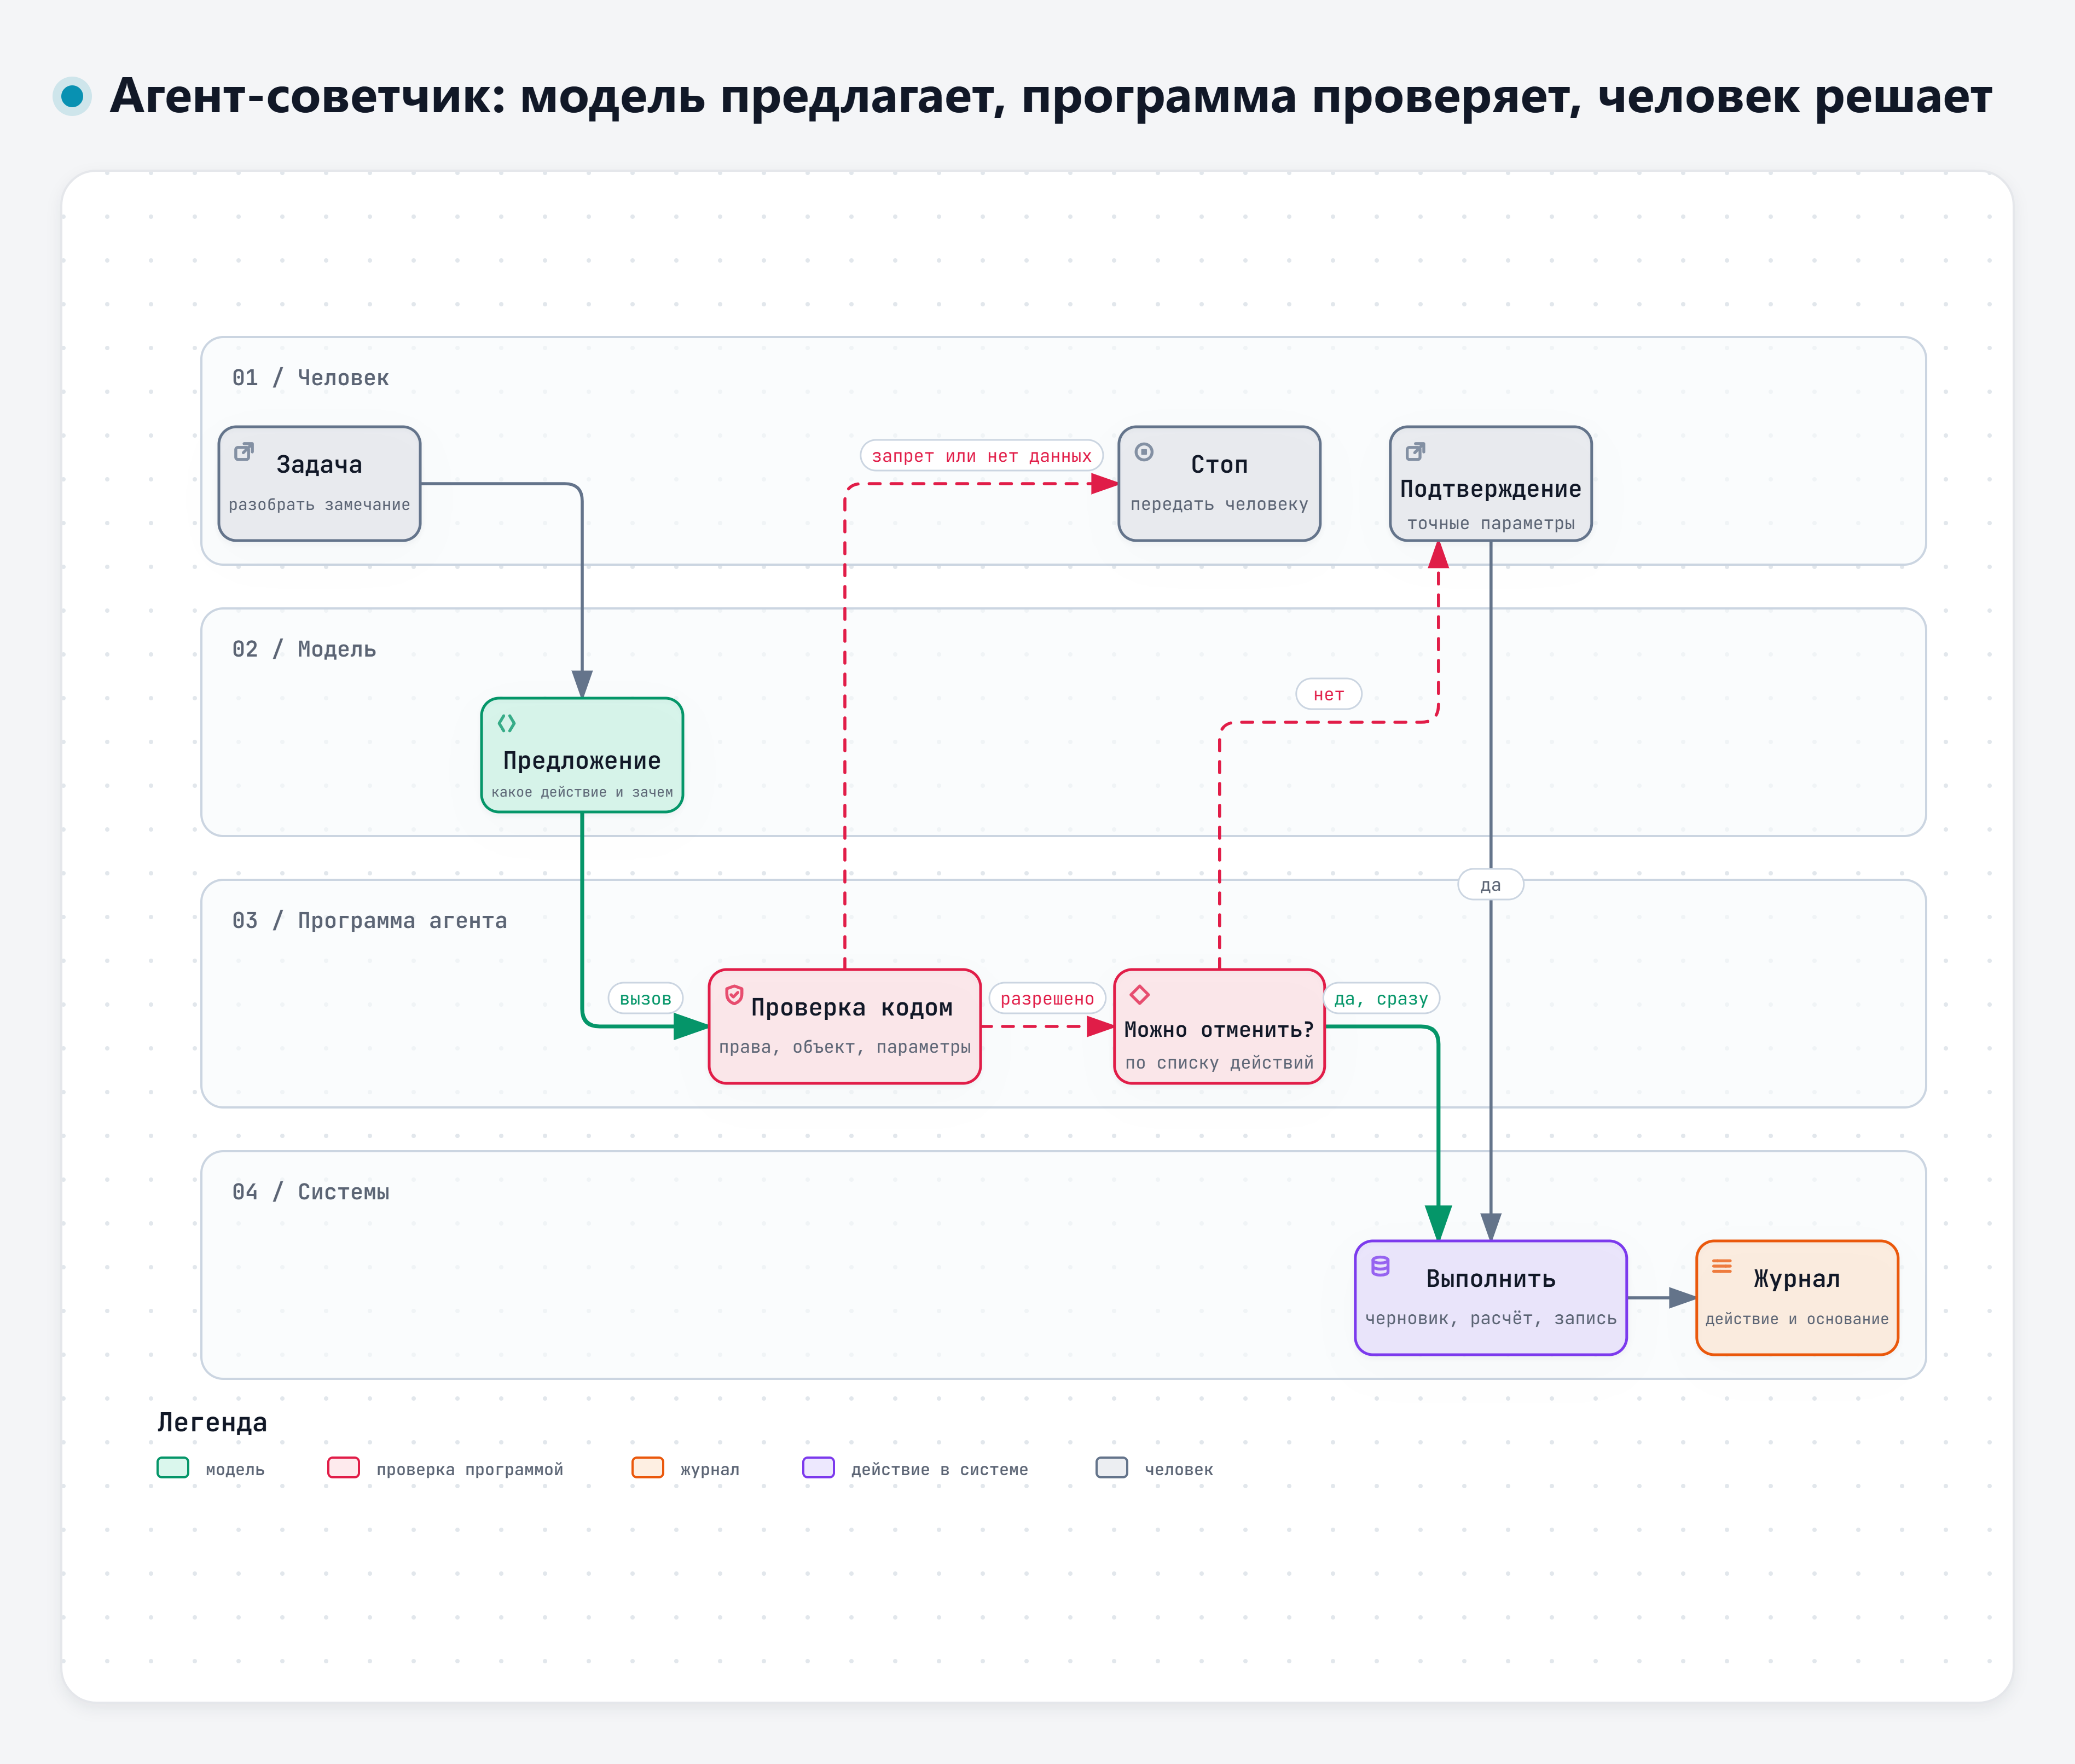
Агент-советчик: модель предлагает, программа проверяет, человек решает
Агент-советчик: модель предлагает, программа проверяет, человек решает – интерактивная схема

К списку вопросов ↑

11 · раздел

Своя база знаний

32 Что такое RAG и Obsidian и как собрать базу знаний о себе, чтобы агент понимал с полуслова и готовил документы?

Коротко

RAG – способ, при котором программа перед ответом находит нужные фрагменты в вашей базе документов, и модель отвечает по ним, а не по памяти. Obsidian – бесплатная программа для заметок, которая хранит их обычными файлами Markdown в папке на вашем диске. Связка простая: заметки о себе, проектах и правилах лежат в папке, агент читает их как контекст, а по большому архиву ищет.

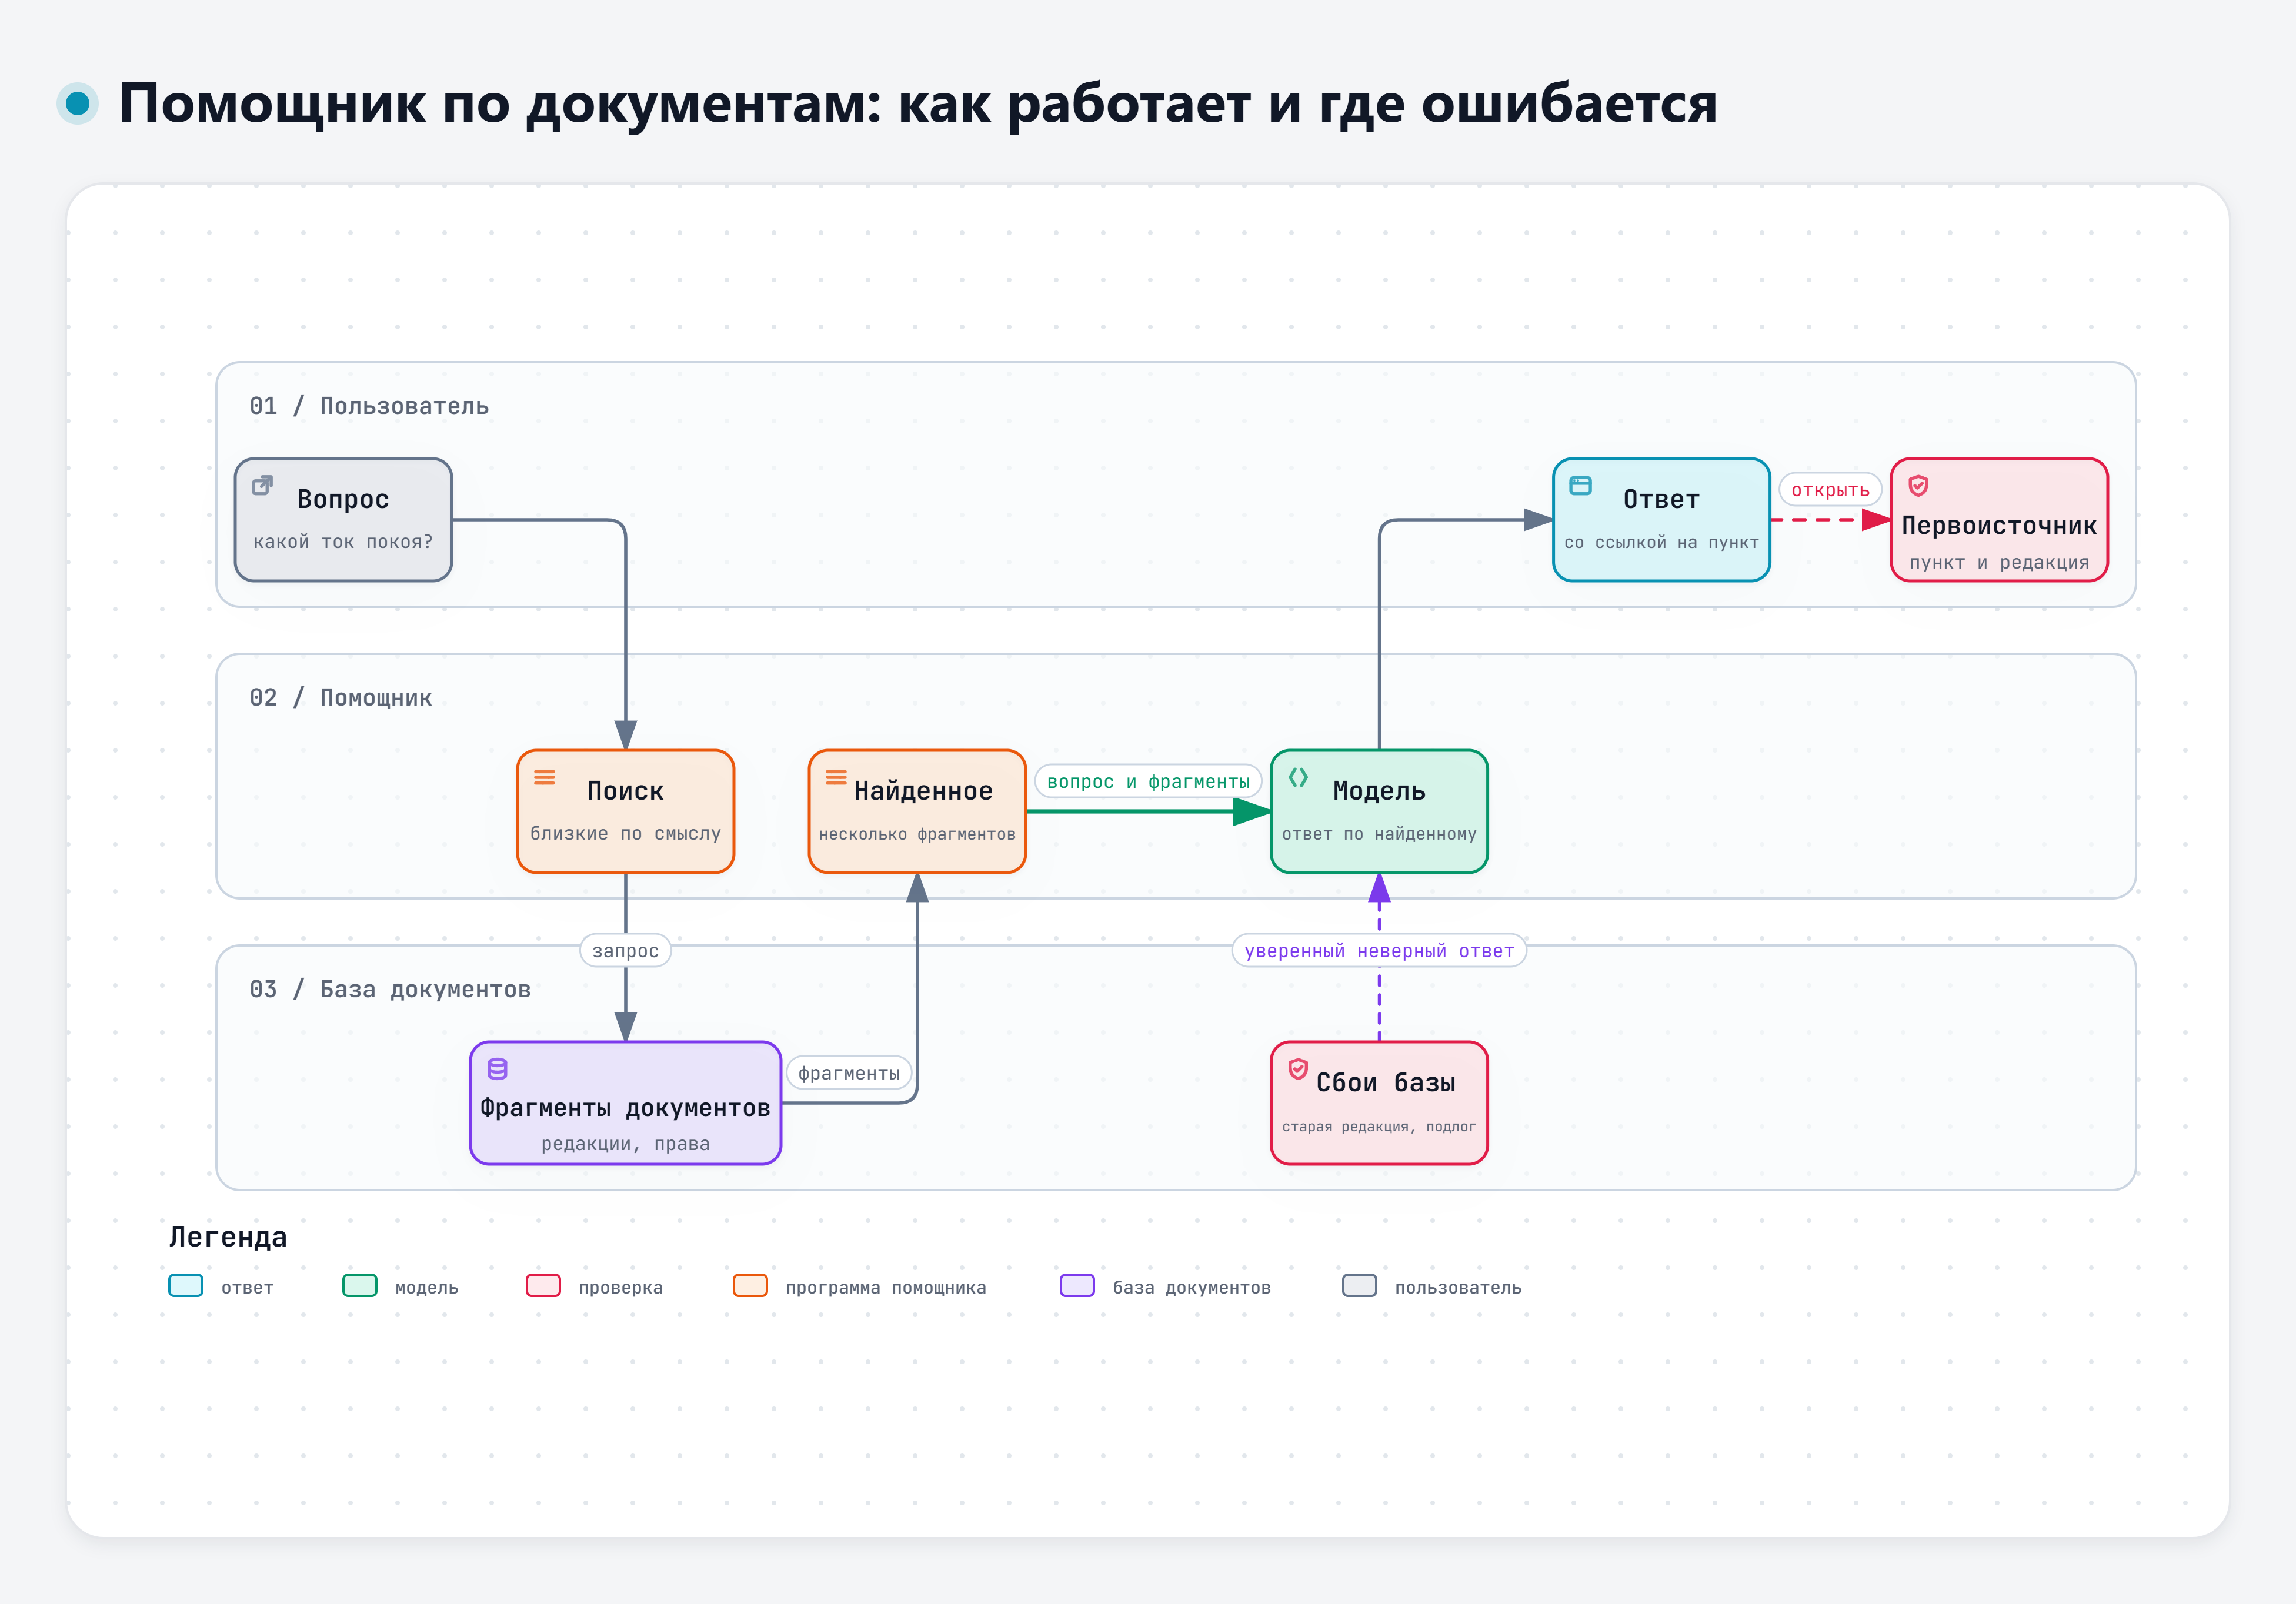
RAG предложили в 2020 году: модель дополняют поиском по внешней базе текстов [166]. Обзор 2026 года называет его ответом на три слабости моделей – выдуманные факты, устаревшие знания и нехватку знаний предметной области [167]. В курсе такой помощник по документам разбирается в теме 2.2.

Помощник по документам: как работает и где ошибается
Помощник по документам: как работает и где ошибается – интерактивная схема

Заметки в Obsidian – обычные текстовые файлы Markdown в хранилище, а хранилище – это просто папка на вашем диске [168]. Программа бесплатна, данные хранятся на устройстве, и, по словам разработчиков, телеметрию она не собирает [169].

Как собрать базу знаний для агента:

  1. Папка с заметками в Markdown: о себе (должность, задачи, реквизиты для документов), о проектах, шаблоны документов, правила оформления, словарь терминов.
  2. Файл-инструкция для агента в корне папки. Claude Code читает файл CLAUDE.md в начале каждой сессии как контекст, а не как жёсткие правила, и советует держать его в пределах 200 строк [170]. Открытый формат AGENTS.md понимают Codex, Gemini CLI, VS Code, Cursor и другие программы [171].
  3. Агент работает в этой папке: читает нужные заметки, а по большому архиву ищет.
  4. Чат-сервисы делают похожее сами: проекты с базой знаний и память у Claude [172], [173], память у ChatGPT [174]. Тогда заметки хранятся у поставщика. У Codex на компьютере память своя, локальная [174], но прочитанное агентом всё равно уходит в запросе к модели.

Чего в такую базу не класть: пароли, персональные данные других людей, сведения работодателя, если правила организации этого не разрешают. Если модель работает в облаке, всё, что агент прочитал, уходит поставщику (вопрос 22).

К списку вопросов ↑

12 · раздел

Автоматизация без программирования: n8n и аналоги

Здесь – как связать почту, таблицы, внутренние системы и языковую модель в цепочку, которая работает сама, и что при этом учесть по безопасности. Сведения раздела – на 16.11.2026: версии, цены и списки уязвимостей меняются быстро.

33 Что такое n8n и зачем он инженеру?

Коротко

n8n – программа для автоматизации: на холсте из готовых блоков собирают рабочий процесс, например «пришло письмо – достать вложение – сверить с требованиями – разослать сводку». Процесс запускается сам, по событию или расписанию, и передаёт данные между почтой, таблицами, базами, внутренними системами и языковыми моделями. Разработчик – немецкая компания n8n GmbH. Поставить n8n у себя и пользоваться им внутри организации можно бесплатно, но это не open source в строгом смысле: лицензия, например, запрещает продавать n8n как сервис.

n8n выпускает компания n8n GmbH из Берлина [175]. Название – сокращение от nodemation: node – от узлов, из которых собирают процесс, и от платформы Node.js, на которой написана программа, -mation – от automation [176].

Исходный код открыт для чтения, а лицензия своя – Sustainable Use License. Она действует для основной ветки master, на содержимое других веток лицензия не выдана. Исключения – файлы с «.ee.» в имени и каталоги с «.ee» в названии: они распространяются по n8n Enterprise License, и в рабочей эксплуатации ими можно пользоваться только с действующей лицензией Enterprise. Копировать и менять этот код для разработки и тестирования та же лицензия разрешает без подписки. Сторонние компоненты в составе n8n сохраняют свои лицензии [177], [178], [179]. Sustainable Use License разрешает пользоваться программой, менять и распространять её с тремя ограничениями [177]:

  • использовать и менять – только для внутренних задач организации, для некоммерческих или личных целей;
  • распространять – только бесплатно и не ради коммерции;
  • не убирать уведомления о лицензии и авторских правах.

Сама компания называет такую модель fair-code и open source n8n не считает: по определению Open Source Initiative открытая лицензия не может ограничивать использование [177].

Разъяснения n8n для организаций [180]:

Можно бесплатно Нельзя без отдельного договора
Автоматизировать работу своей организации Предоставлять n8n как сервис, в котором клиенты сами строят процессы
Держать несколько экземпляров Давать внешним пользователям настраивать процессы – через свой интерфейс, API, MCP или ИИ-агента
Строить автоматизации для клиентов на своём экземпляре, если клиенты их не меняют Делать на основе кода n8n свой продукт для автоматизации или выдавать n8n под своим брендом
Брать плату за настройку, сопровождение и обучение Включать функции Enterprise без лицензионного ключа

Главное правило там же: если рабочие процессы создают или меняют только сотрудники вашей организации, n8n можно использовать бесплатно [180]. Внутренняя автоматизация инженерного отдела под это правило подходит (вывод автора). Но ставить ли программу на работе, решает организация (тема 2.1).

Два варианта работы [181], [182], [183]:

n8n Cloud Своя установка
Кто обслуживает n8n вы или ваша ИТ-служба
Где данные серверы Microsoft Azure в ЕС, например в Германии и Швеции на вашей инфраструктуре; что уходит наружу, зависит от подключённых сервисов, моделей и ИИ-функций (вопрос 37)
Стоимость 14 дней пробно, дальше платно редакция Community бесплатна, Business и Enterprise платные
Сведения об использовании для n8n отключить нельзя, сеансы работы в интерфейсе записываются и удаляются через 21 день отправляются по умолчанию, отключаются переменными окружения; при платной лицензии счётчики использования и идентификатор лицензии передаются всё равно

Цены на 16.11.2026 – в евро в месяц при оплате за год: Starter – 20 € за 2,5 тыс. выполнений процессов, Pro – 50 € за 10 тыс., Business – 667 € за 40 тыс. (только для своей установки; на сайте описан как план для компаний численностью менее 100 сотрудников), Enterprise – по запросу. Платят за выполнения, а не за пользователей и шаги: число пользователей и процессов во всех планах не ограничено [184]. Пробный период – 14 дней с функциями Pro и лимитом 1000 выполнений, после него экземпляр удаляется, если не перейти на платный план [185].

Готовые интеграции n8n называет узлами. В описании репозитория их больше 1500, в каталоге на сайте – больше 2000 [176], [186]. К сервису без готового узла подключаются универсальным узлом HTTP Request [187].

Зачем это инженеру (вывод автора): связать системы, которые сами друг с другом не обмениваются данными, и убрать ручное перекладывание. Выгрузка из одной системы, сверка, уведомление, отчёт по расписанию – типичные задачи. Языковая модель в такой цепочке – один шаг, там, где нужно прочитать или написать текст.

К списку вопросов ↑

34 Как устроен n8n и как собрать первый сценарий с ИИ?

Коротко

Рабочий процесс – цепочка узлов на холсте. Первый узел – триггер: он запускает процесс по расписанию, по входящему письму или по обращению к адресу-вебхуку. Следующие узлы читают, преобразуют и отправляют данные, а пароли и ключи к сервисам хранятся отдельно, в учётных данных. Попробовать n8n можно на своём компьютере одной командой Docker.

Основные понятия по документации n8n:

Понятие Что это
Рабочий процесс (workflow) Набор узлов, который автоматизирует процесс. Запускается по триггеру, вручную или из другого процесса, может ветвиться, сливаться и повторять шаги [188]
Триггер Узел, который запускает процесс при заданном условии. Рабочему процессу в эксплуатации нужен хотя бы один триггер [188]
Узел (node) Отдельный шаг: получает, обрабатывает или отправляет данные [187]
Выражение (expression) Вставка вида {{$json.body.city}}, которая подставляет в настройку узла значение из предыдущих шагов. Внутри выражения – JavaScript [188], [189]
Учётные данные (credentials) Логины и пароли, ключи API, секреты OAuth для подключения к сервисам [188]
Выполнение (execution) Один запуск процесса. Выполнения можно просматривать и фильтровать, и по ним видно, что процесс делал [190]

Триггеры, которые понадобятся чаще всего:

  • Schedule Trigger – запуск через заданные интервалы или по расписанию в формате cron. Процесс с ним нужно опубликовать, а часовой пояс задать: у своей установки по умолчанию стоит America/New York [191].
  • Webhook – запуск, когда другая система обращается к адресу процесса. Есть тестовый адрес для отладки и рабочий, который появляется после публикации. Проверка подлинности задаётся в узле, например Basic, Header или JWT, а вариант None означает работу без проверки [192].
  • Email Trigger (IMAP) – запуск по новому письму в ящике, вложения можно сохранять [193].

Как поставить у себя для пробы. Нужен Docker: Docker Desktop, а на Linux можно поставить отдельно Docker Engine [194]. Команды взяты из документации n8n [194], часовой пояс подставлен московский, а порт опубликован только для своего компьютера:

docker volume create n8n_data
docker run -it --rm --name n8n -p 127.0.0.1:5678:5678 -e GENERIC_TIMEZONE="Europe/Moscow" -e TZ="Europe/Moscow" -e N8N_ENFORCE_SETTINGS_FILE_PERMISSIONS=true -v n8n_data:/home/node/.n8n n8nio/n8n

После запуска n8n открывается в браузере по адресу localhost:5678. Том n8n_data хранит процессы, учётные данные и ключ шифрования между перезапусками [194]. В команде из документации стоит -p 5678:5678, но Docker сам предупреждает: так опубликованный порт доступен не только с этого компьютера. С адресом 127.0.0.1 к порту может обратиться только сам компьютер, но в Docker Engine до версии 28.0.0 такой порт был доступен и соседним машинам в том же сегменте сети L2 [195]. Поэтому перед пробой проверяют версию Docker (вывод автора).

Три оговорки:

  • страница с этой командой в документации помечена устаревшей, для постоянной установки n8n советует Docker Compose, а на Windows – через WSL с Docker Desktop или с Docker Engine внутри дистрибутива Linux [194], [196];
  • без установки можно запустить npx n8n, если есть Node.js версии от 20.19 до 24.x, но установку через npm n8n объявил устаревшей с версии 3.0 [197];
  • рабочую установку n8n советует доверять специалистам: ошибки в ней ведут к потере данных и проблемам с безопасностью [194]. Для работы n8n ставит ИТ-служба, а не сотрудник на свой компьютер (тема 2.1).

Первый сценарий: протокол испытаний приходит письмом, n8n сверяет его с требованиями и готовит ответ, который отправляется только после проверки человеком. Ниже – схема. Узлы и настройки названы по документации n8n. Сначала сценарий проверяют на тестовом ящике и вымышленном протоколе, рабочие данные подключают только с разрешения организации (тема 2.1).

  1. Узел Email Trigger (IMAP) следит за тестовым ящиком, настройка Download Attachments сохраняет вложение [193].
  2. Узел Extract From File превращает вложение в формате XLSX или CSV в записи JSON, по одной на строку таблицы [198]. Из PDF узел извлекает текстовые поля, поэтому таблицу надёжнее присылать в XLSX или CSV (вывод автора).
  3. Узел Code на JavaScript или Python сверяет каждое значение с допуском из чек-листа и составляет список расхождений [199]. Числа сверяет программа, а не модель (вопрос 2).
  4. Узел AI Agent с подключённой моделью получает список расхождений и пишет черновик ответа [200]. Модель – локальная через Ollama или та, которую разрешила организация (вопрос 35).
  5. Письмо агент отправляет инструментом Send Email, а инструмент стоит за шагом Human review. Процесс останавливается, проверяющий видит, какой инструмент и с какими параметрами хочет вызвать агент, и нажимает «одобрить» или «отклонить». При отказе отправка отменяется, и агент получает об этом сообщение [201], [202].
  6. Сохранённые запуски видны в списке выполнений, данные рабочего запуска можно открыть на вкладке Executions [192], [190]. Сохранять ли успешные, неуспешные и ручные запуски, задают настройки процесса [203], срок хранения данных – настройки экземпляра [182], а при удалении процесса удаляется и его история выполнений [204]. Перед учебным запуском эти настройки проверяют.

Запрос на согласование n8n умеет показывать во встроенном чате, а также отправлять в Slack, Telegram, Microsoft Teams, Gmail, Outlook и другие сервисы [202]. Все они, кроме встроенного чата, внешние, для рабочих процессов подходят только разрешённые в организации.

К списку вопросов ↑

35 Чем рабочий процесс n8n отличается от агента и как подключить модели?

Коротко

Обычный рабочий процесс n8n – цепочка в смысле вопроса 27: шаги и правила переходов между ними заранее задал человек, а по какой ветке пойдёт конкретный запуск, решают входные данные и условия. Агент сам решает, какой инструмент вызвать дальше. В n8n есть и то и другое: узел AI Agent внутри процесса и отдельные агенты. Практичная схема – проверяемые шаги делать обычными узлами, а модель ставить только туда, где нужно понять или написать текст (вывод автора).

Разницу между цепочкой и агентом разработчики моделей описывают так же: в цепочке ход работы задан кодом, в агенте его выбирает модель [142]. В n8n узел AI Agent получает модель и хотя бы один инструмент и сам решает, какие инструменты вызвать [200]. Модель, память и инструменты подключаются к нему как вложенные узлы [188]. Отдельно в n8n есть агенты: самостоятельные помощники со своими инструкциями, инструментами, навыками и базой знаний, к которым обращаются через чат и каналы. На 16.11.2026 они в предварительной версии (Preview) [188].

Задача Чем делать (вывод автора)
Шаги известны и повторяются: забрать файл, сверить, разослать Рабочий процесс из обычных узлов
В середине нужен текст: сводка, разбор письма по темам, черновик ответа Узел модели или AI Agent внутри процесса
Шаги заранее неизвестны, решать нужно по ходу Агент (вопрос 27) с минимумом прав (вопрос 31)

В испытании SOP-Bench агенты на языковых моделях выполняли более 2000 задач по регламентам из 12 областей – медицины, логистики, финансов и других – и с многошаговыми процедурами справлялись с трудом. Лучший результат по разным областям – от 57 до 100 %, а более новая модель не всегда работала лучше. По сводной таблице статьи и её аннотации средняя по процедурам доля успешно выполненных задач в режиме ReAct у Claude 4 Opus – 72,4 %, у Claude 4.5 Sonnet – 63,3 %; в тексте статьи для Claude 4 Opus встречается и 73,8 % [205]. Поэтому смену модели в рабочем процессе нужно проверять заново (вывод автора). В работе о применении n8n, Zapier и Make в администрировании Linux авторы выделили n8n, потому что его можно поставить у себя и дополнять. Их вывод: такие платформы ускоряют интеграцию, держат учётные данные в одном месте и сохраняют историю выполнений, а точное управление лучше оставлять программам. Авторы советуют смешанную схему: платформа запускает процессы, распределяет данные, вызывает модели и ждёт согласования, а операции, чувствительные к скорости, выполняют штатные средства Linux [206].

Какие модели подключаются:

  • облачные OpenAI, Anthropic, Google и другие – через свои узлы и учётные данные [207];
  • локальные через Ollama (вопрос 24) – в учётных данных указывают адрес Ollama, по умолчанию localhost:11434. Если n8n и Ollama работают в разных контейнерах Docker, их подключают к одной сети и вместо адреса пишут имя контейнера [208]. Для пробы у n8n есть готовый набор Self-hosted AI Starter Kit: n8n, Ollama, Qdrant и PostgreSQL [209];
  • через OpenAI-совместимый API. В учётных данных OpenAI есть поле Base URL, которое заменяет адрес по умолчанию. В документации n8n оно не описано, его видно в исходном коде [210]. Так можно указать сервис, который принимает запросы в формате OpenAI. Такой API публикует, например, Yandex AI Studio [211]. Работает ли с n8n конкретный сервис, проверяют на тестовых данных (вывод автора);
  • в n8n Cloud модели можно вызывать без своего ключа, за кредиты n8n [212]. В перечне подрядчиков n8n есть поставщики моделей OpenAI и Anthropic с обработкой данных в США [183].

MCP (вопрос 29) n8n поддерживает в обе стороны [188]:

  • как клиент: узел MCP Client Tool даёт агенту инструменты внешнего сервера MCP, и можно оставить все инструменты, только выбранные или все, кроме выбранных [213]. В панели узлов есть реестр серверов MCP, они подключаются в один клик [214];
  • как сервер: узел MCP Server Trigger открывает инструменты и процессы n8n внешним клиентам MCP по своему адресу. Проверку подлинности выбирают в узле, среди вариантов есть None – без проверки [215]. Сервер MCP всего экземпляра позволяет клиенту, например Claude, создавать, менять и запускать процессы [188].

Документация n8n сама сравнивает два способа дать агенту доступ к сервису. Встроенный узел-инструмент даёт больше контроля: операция задана заранее, параметры можно закрепить, и модель заполняет только оставленные ей поля. Сервер MCP даёт агенту больше свободы, но контроля меньше [214]. Для действий, которые меняют данные или отправляют что-то наружу, надёжнее первый способ (вывод автора).

К списку вопросов ↑

36 Какие есть аналоги n8n и что выбрать?

Коротко

Ближе всего к n8n облачные Zapier и Make: с ними можно начать без своего сервера (вывод автора). Если ставить нужно у себя, смотрят Node-RED, Activepieces и Windmill, а для конвейеров данных на Python – Apache Airflow. Из российских – Albato с серверами в России, по заявлению компании, и Yandex Workflows в облаке Яндекса. Для рабочих задач годится только то, что разрешено в организации.

Инструмент Где работает Лицензия ИИ Порог входа (вывод автора)
n8n n8n Cloud или своя установка Sustainable Use License (fair-code), часть функций – по ключу Enterprise [177] AI Agent, модели, MCP в обе стороны (вопрос 35) Средний
Zapier Облако, своей установки на странице тарифов нет [216] Платный сервис, есть бесплатный план на 100 задач в месяц [216] Агенты Zapier Agents, Zapier MCP [217], [216] Низкий
Make (компания Celonis [218]) Облако. В плане Enterprise есть локальный агент, через который сценарии обращаются к системам в локальной сети [219] Платный сервис, есть бесплатный план [220] ИИ-агенты, сервер MCP [218], [220] Низкий
Node-RED (OpenJS Foundation) Своя установка, в том числе на Raspberry Pi, и облако [221] Apache 2.0 [222] Через узлы сообщества, например для Ollama [223] Средний
Activepieces Облако или своя установка [224] Community Edition – MIT, функции Enterprise – по коммерческой лицензии [225] ИИ-блоки и агенты, интеграции доступны как серверы MCP, есть согласование человеком [225] Низкий
Windmill Своя установка через Docker Compose или выделенный экземпляр у разработчика [226] Исходный код – AGPLv3 и Apache 2.0, часть функций закрыта. Готовые образы Community Edition содержат и закрытый код [227] ИИ-сеансы для сборки сценариев, сервер MCP [226] Высокий: сценарии пишут кодом на Python, TypeScript, Go и других языках [226]
Apache Airflow Своя установка Apache 2.0 [228] Провайдер common.ai: вызовы моделей и агенты с инструментами, пауза для одобрения человеком [229] Высокий: процессы описывают кодом на Python [228]
Albato (ООО «Альбато», Москва) Облако. По заявлению компании, серверы в России, данные обрабатываются по 152-ФЗ [230], [231] Платный сервис с тарифами [230] ИИ-агенты, ИИ-ассистент, который сам собирает сценарий, ИИ-инструменты ChatGPT, Gemini, Claude и другие [232] Низкий
Yandex Workflows Облако Яндекса [233] Облачный сервис Яндекса Шаг вызова моделей Yandex AI Studio: генерация текста, классификация, работа с изображениями [234] Средний: шаги описывают в спецификации YaWL или в конструкторе [233]

Node-RED по описанию проекта применяют от домашней автоматизации до промышленных систем управления [221]. Albato заявляет связь с более чем 1000 приложений [232]. ChatGPT, Gemini и Claude среди его ИИ-инструментов – зарубежные модели, и текст для них уходит к их поставщикам (вывод автора). Русскоязычный сервис ApiX-Drive – не российский: его предоставляет эстонская компания Apicom Solutions OÜ, и условия использования не допускают граждан и компании России и Беларуси [235].

Как выбирать (вывод автора):

  • проверить идею за вечер на вымышленных данных – облачный сервис с бесплатным планом, рабочие данные туда – только с разрешения организации;
  • данные не должны покидать организацию – своя установка: n8n, Node-RED, Activepieces или Windmill, которую ставит и обновляет ИТ-служба. Сама по себе она этого не гарантирует: подключённые облачные модели, интеграции и встроенные ИИ-функции могут передавать данные наружу, поэтому ИТ-служба размещает нужные компоненты внутри и проверяет внешние соединения;
  • датчики, контроллеры, промышленные протоколы – Node-RED;
  • конвейеры данных, которые пишут программисты, – Airflow или Windmill;
  • до выбора прочитать лицензию: у n8n и Windmill есть ограничения на перепродажу и встраивание в свой продукт [180], [227].

К списку вопросов ↑

37 Что учесть по безопасности, если ставить n8n у себя?

Коротко

В n8n хранятся ключи и пароли ко всем подключённым системам, поэтому захват n8n открывает доступ сразу ко всем (вывод автора). Уязвимости в n8n находят регулярно: только в 2026 году опубликовано больше сотни бюллетеней высокого и критического уровня. Минимум мер: вовремя обновлять, не выставлять n8n в интернет, давать право менять процессы только доверенным людям и оставлять человеку подтверждение необратимых действий. Рабочие данные – только в n8n, который развернула или разрешила организация.

В разделе бюллетеней безопасности репозитория n8n на 16.11.2026 опубликовано 242 бюллетеня: 22 критических, 104 высокого уровня, 114 среднего и 2 низкого. В 2026 году вышли 228 из них, в том числе 118 критических и высокого уровня [236]. Примеры критических:

Номер Суть Оценка CVSS Затронутые версии Исправлено в
CVE-2026-21858 [237], [238] Доступ к файлам сервера через некоторые процессы с формами, учётная запись атакующему не нужна 10,0 – CVSS 3.1, оценка GitHub, своей оценки в NVD нет >=1.65.0, <1.121.0 1.121.0
CVE-2025-68613 [239], [240] Выполнение кода через выражения в настройках процесса, нужна учётная запись 9,9 – CVSS 3.1, GitHub; 8,8 – CVSS 3.1, NVD По NVD: >=0.211.0, <1.120.4, а также 1.121.0 1.120.4, 1.121.1, 1.122.0 (по NVD)
CVE-2026-25049 [241], [242] Новые способы атаки через выражения, найденные после CVE-2025-68613 9,4 – CVSS 4.0, GitHub; 9,9 – CVSS 3.1, NVD <1.123.17, а также >=2.0.0, <2.5.2 1.123.17, 2.5.2
CVE-2026-21877 [243], [244] Выполнение кода через запись файлов, затронуты и своя установка, и n8n Cloud 9,9 – CVSS 3.1, GitHub >=0.123.0, <1.121.3 1.121.3
CVE-2025-68668 [245], [246] Выход из песочницы узла Code на Python в варианте на Pyodide и выполнение команд на сервере 9,9 – CVSS 3.1, GitHub и NVD >=1.0.0, <2.0.0 2.0.0

Знак < означает, что указанная версия уже не затронута. Для CVE-2025-68613 диапазон взят из NVD: в бюллетене n8n поля версий расходятся с его текстом [239], [240].

CVE-2025-68613 по данным NVD 11.03.2026 внесена в каталог известных эксплуатируемых уязвимостей CISA, то есть её уже применяли в атаках [240].

По векторам CVSS из бюллетеней, в 21 критической уязвимости из 22 атакующему нужна учётная запись в n8n, у CVE-2025-68613 вектор взят из NVD (вывод автора по данным [236], [240]). Описания говорят прямо: пользователь с правом создавать и менять процессы мог выполнить команды на сервере [241], для CVE-2025-68668 – с правами процесса n8n [245]. Отсюда правило (вывод автора): это право высокопривилегированное, а тяжесть последствий зависит от прав процесса n8n в системе, изоляции и сетевого доступа. Поэтому сам n8n запускают с ограниченными правами в системе и ограниченным доступом к сети – такую среду n8n советует как временную меру до обновления [239].

Что делать:

  1. Обновлять. Новая минорная версия n8n выходит почти каждую неделю [194], исправленные версии указаны в бюллетенях [236]. Обновление – плановая работа ИТ-службы с понятным сроком.
  2. Не выставлять в интернет. Доступ к n8n оставляют только из внутренней сети организации (вывод автора), а шифрование TLS n8n советует настроить через обратный прокси [247]. Для CVE-2026-21858 n8n советовал до обновления ограничить или отключить общедоступные вебхуки и формы [237]. В узлах Webhook и MCP Server Trigger выбирают проверку подлинности, а не вариант None [192], [215].
  3. Беречь учётные данные. Для подключений заводят отдельные служебные учётные записи с минимальными правами (вывод автора), а где возможно, подключаются через OAuth – так советует n8n [247]. Поле Allowed HTTP Request Domains ограничивает адреса, на которые узел HTTP Request может отправить ключ [248]. Учётные данные n8n шифрует ключом, который создаёт при первом запуске и хранит в папке ~/.n8n [249], поэтому резервную копию этой папки защищают так же, как сами пароли. Личные пароли сотрудников в n8n не вносят (тема 2.1).
  4. Ограничить права и узлы. Если с n8n работают несколько человек, включают управление пользователями [247], а менять процессы разрешают только доверенным – так советует сам n8n в бюллетенях [239]. Опасные узлы отключают переменной NODES_EXCLUDE, n8n предлагает начать с Execute Command и Read/Write Files from Disk, а Execute Command уже отключён по умолчанию [250]. Узлы сообщества получают полный доступ к машине, на которой работает n8n, их тоже можно отключить [251].
  5. Смотреть журнал и проверять настройки. По списку выполнений видно, что делал каждый сохранённый запуск [190]. Команда n8n audit выдаёт отчёт о рисках: неиспользуемые учётные данные, выражения в запросах к базам, рискованные узлы, вебхуки без защиты, устаревшая версия [252]. В выполнениях остаются обработанные данные, и n8n советует настроить их автоматическое удаление раз в несколько дней переменной EXECUTIONS_DATA_MAX_AGE [182].
  6. Оставить человека на согласовании. Отправка писем, изменение и удаление записей – через Human review (вопрос 34) [202]. Это мера из перечня OWASP против избыточной самостоятельности (вопрос 30) [157].
  7. Знать, что уходит наружу. Своя установка по умолчанию отправляет n8n сведения об использовании: устройство процессов, ошибки, счётчики. Данные процессов и учётные данные в них не входят. Отключается это переменными окружения, например N8N_DIAGNOSTICS_ENABLED=false для событий телеметрии. Если лицензия платная, счётчики использования и идентификатор лицензии передаются всё равно: эту отчётность отключить нельзя. Встроенный помощник n8n Assistant отправляет моделям описание открытого процесса, его код и выражения [182].

С облаком отдельный вопрос – где лежат данные. n8n Cloud работает на серверах в ЕС [183], и по условиям n8n содержимое клиентов не используется для обучения моделей [253]. Но персональные данные на таких серверах – это трансграничная передача со своими обязанностями оператора (вопрос 23) [119], [120]. Правило курса не меняется: рабочие данные – только в сервисы, разрешённые организацией (тема 2.1).

К списку вопросов ↑

13 · раздел

Формат Markdown: что это и как с ним работать

Материалы курса выложены в двух видах: страница для чтения в браузере и файл .md. Здесь – чем открыть файл .md без лишних программ, куда записывать свои ответы, почему курс и языковые модели работают с Markdown и как переводить в него документы Word, PDF и Excel. Сведения о программах – на 16.11.2026.

38 Скачал материал, а там файл .md. Как его прочитать, не устанавливая сложных программ?

Коротко

Проще всего ничего не скачивать: на странице дня у каждого материала есть кнопка «Читать», она открывает тот же материал свёрстанной страницей в браузере. Если файл .md уже скачан, его открывает Блокнот или любой другой текстовый редактор: это обычный текст, только с пометками вроде # перед заголовками и ** вокруг жирных слов. Читать его можно и так. Visual Studio Code для чтения не нужен, он пригодится тем, кто хочет править текст.

Способ 1. Версия для чтения на сайте курса. На странице каждого дня, в разделе «Лекции, практика, задания», у материала две ссылки: «Читать» открывает страницу в браузере, «Markdown» скачивает файл для работы без интернета. Для чтения достаточно первой. Если интернета не будет, заранее скачайте архив дня и распакуйте его: у каждого материала рядом с файлом .md лежит файл .html с тем же именем. Двойной щелчок по нему открывает страницу в браузере, интернет для неё не нужен.

Способ 2. Блокнот или другой текстовый редактор. Файл .md – обычный текстовый файл. Создатель формата Джон Грубер задумывал его так, чтобы документ в Markdown можно было публиковать как есть, простым текстом, и он не выглядел бы набором служебных тегов [254]. Открыть такой файл можно в любом текстовом редакторе. Если файл не открывается двойным щелчком, щёлкните по нему правой кнопкой мыши, выберите «Открыть с помощью» и затем «Блокнот».

Что означают значки, которые вы увидите:

В тексте Что это
# Тема 1.1, ## 1. Что такое… Заголовки: чем больше решёток, тем ниже уровень
**модель** Жирный шрифт
- пункт или 1. пункт Пункт списка
Строки с вертикальными чертами, под первой строкой – дефисы Таблица
[текст](адрес) Ссылка: в квадратных скобках – текст, в круглых – адрес
Текст между обратными апострофами ` Команда, имя файла или фрагмент программы

Подробнее о каждом значке – в вопросе 43.

В новых версиях Блокнота Windows 11 Microsoft добавила оформление Markdown. В мае 2025 года его начали выдавать участникам программы Windows Insider: заголовки, жирный и курсивный шрифт, ссылки и списки показываются оформленными, а в меню «Вид» можно переключаться между оформленным текстом и исходной разметкой. Оформление можно совсем выключить в настройках программы [255]. В журнале изменений Блокнота за июль 2026 года отмечено, что оформление теперь правильно применяется к файлам .md и .markdown [256]. Оба источника описывают сборки для участников Windows Insider, поэтому увидите ли вы оформление, зависит от версии Windows и Блокнота на вашем компьютере (вывод автора). Если не увидите, ничего страшного: тот же текст будет показан со значками из таблицы.

Способ 3. Word. Открывает ли Word файл .md, зависит от версии. В октябре 2026 года Microsoft сообщила о поддержке Markdown в Word: при наборе можно пользоваться разметкой Markdown, текст копируется между Word и Markdown с сохранением оформления, а в веб-версии Word файлы можно преобразовывать из .md в .docx и обратно [257]. Подтверждено только преобразование в веб-версии Word, о настольном Word в сообщении ничего не сказано. Если в вашей версии Word открыть .md не получается, пользуйтесь способами 1 и 2.

Способ 4. Obsidian – программа для заметок в Markdown. Её уже упоминали в вопросе 32. Obsidian хранит заметки обычными файлами Markdown в папке на диске [168], а готовую папку, например с распакованным архивом курса, можно открыть как хранилище командой «Open folder as vault» [258]. В режиме чтения заметка показывается без значков разметки, переключение – сочетанием клавиш Ctrl+E [258]. Программа бесплатна для любых целей, в том числе для работы [259]. Её нужно устанавливать, поэтому для чтения материалов курса она не обязательна.

Для тех, кто хочет править текст: Visual Studio Code. Редактор бесплатен для личного и коммерческого использования [260]. С Markdown он работает сразу после установки: Ctrl+Shift+V открывает просмотр оформленного текста, Ctrl+K V – просмотр рядом с редактором, и просмотр обновляется по мере набора [260]. Для чтения материалов курса эта программа не нужна.

Любые программы и расширения браузера на рабочий компьютер ставят только с разрешения организации (тема 2.1). Способы 1 и 2 ничего устанавливать не требуют.
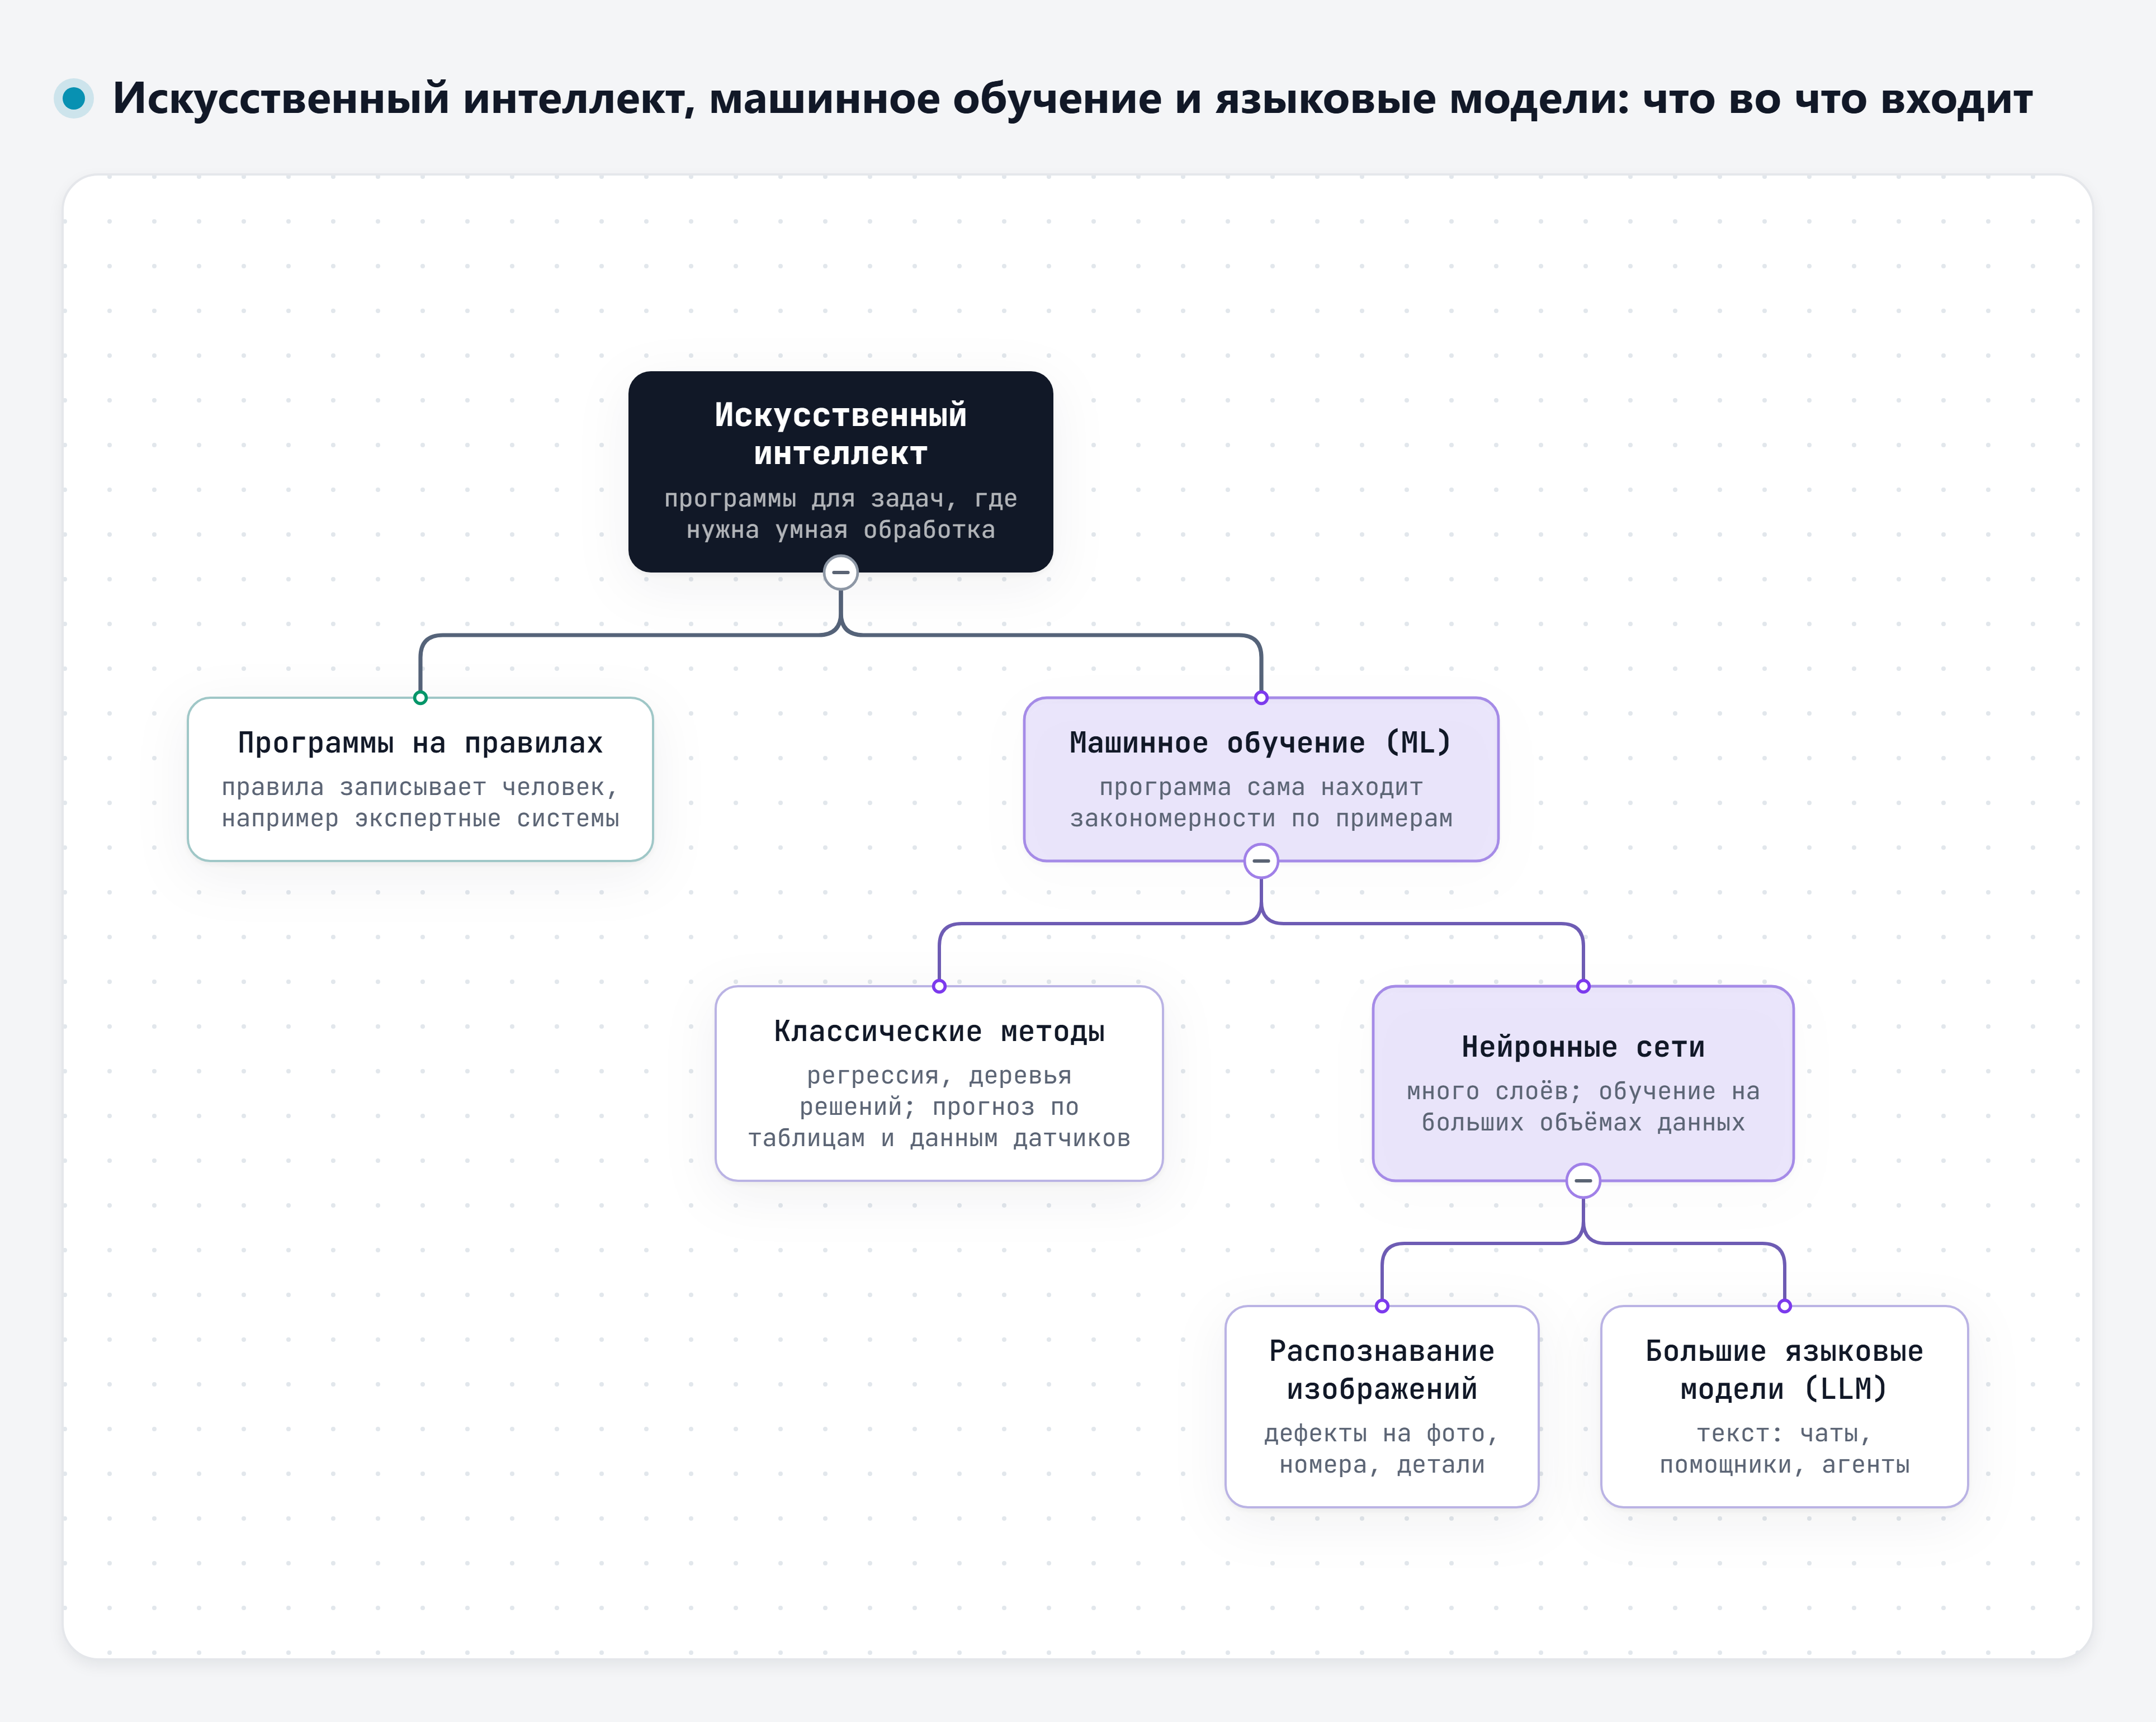
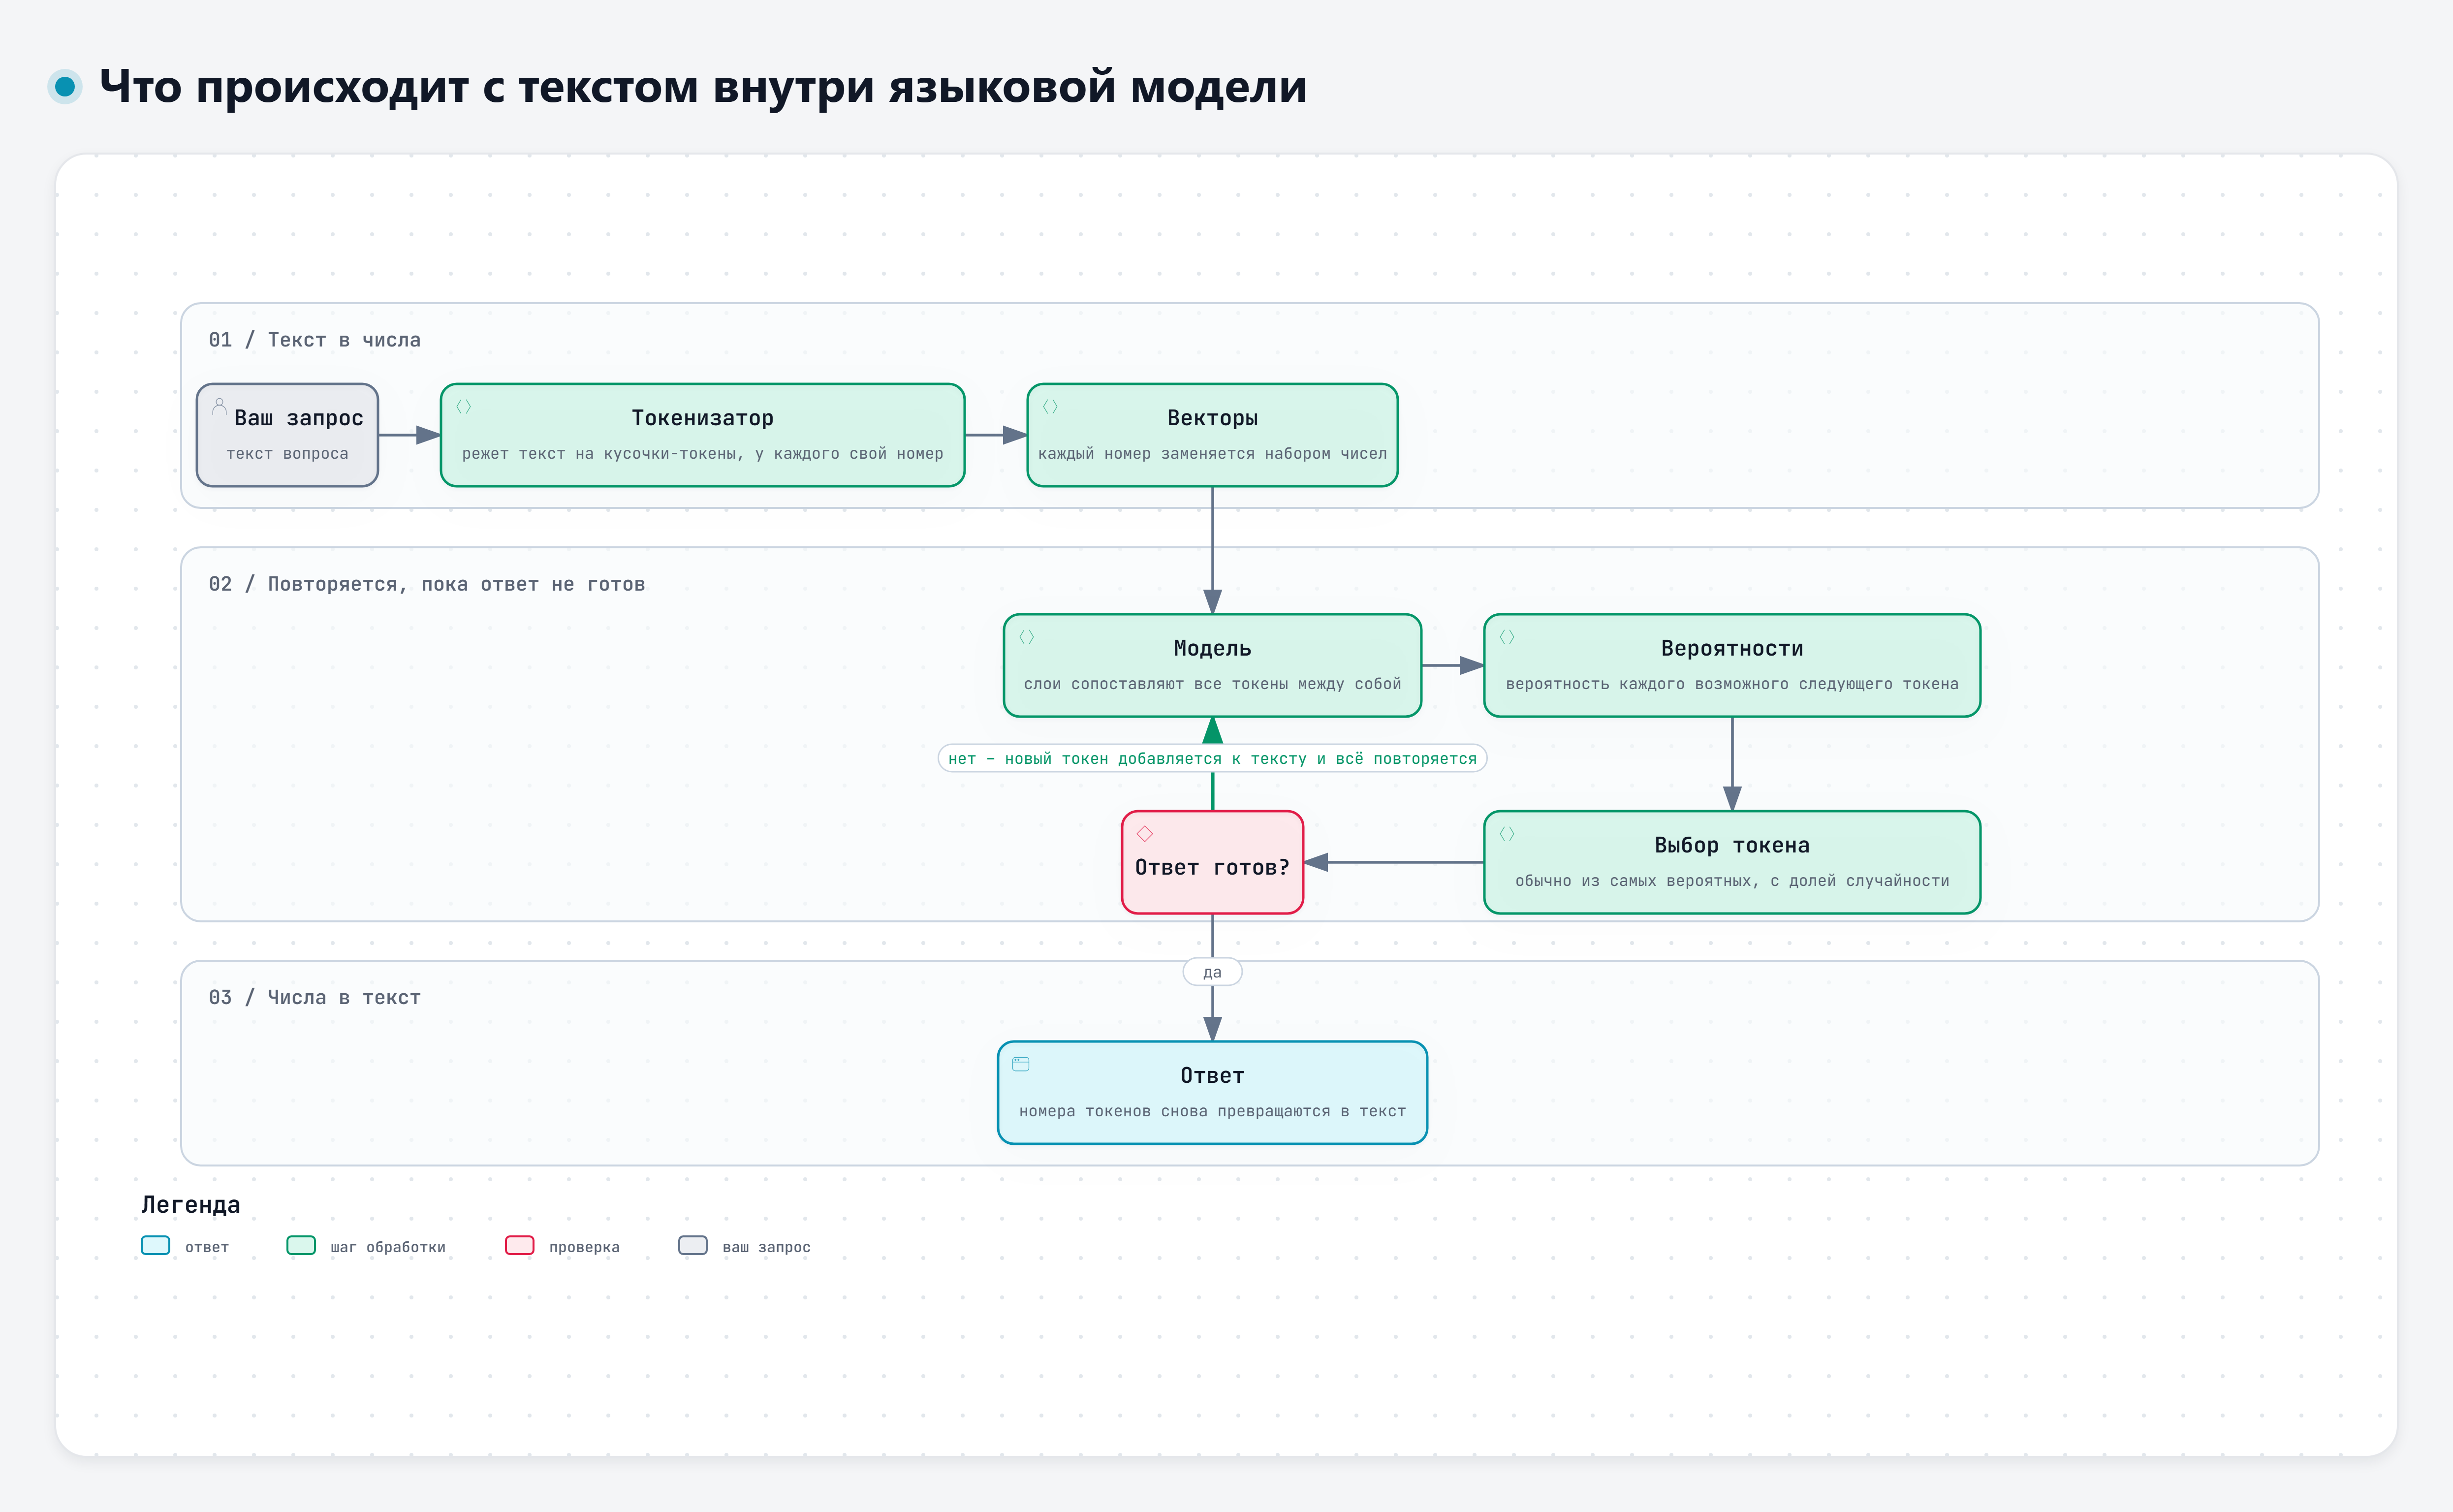
К списку вопросов ↑

39 На сайте – HTML-страницы и файлы .md, их не заполнить. Где писать ответы?

Коротко

В рабочей тетради итогового проекта – файле Word. Страницы HTML и файлы .md – материалы для чтения, в них ничего заполнять и никуда отправлять не нужно. Тетрадь скачивается архивом, в нём файл Word для заполнения и PDF для просмотра.

Где взять тетрадь: на главной странице сайта курса, под программой, и на странице первого дня в разделе самостоятельной работы – ссылка «Скачать рабочую тетрадь (ZIP: Word и PDF)». Тетрадь одна на весь курс: после каждого модуля вы заполняете его раздел и загружаете тетрадь целиком на Платформу в задание контрольной точки. Для первого модуля это задание «Контрольная точка по модулю 1»: заполнить титул и раздел 1 и загрузить тетрадь.

У тетради на странице дня тоже есть ссылки «Читать» и «Markdown». Это описание тетради: что писать в каждом разделе. В самой тетради так и сказано: заполняйте файл Word, а этот текст держите как описание.

Если понадобится копия заполненной тетради в PDF, её сохраняет сам Word. В Word для Windows: «Файл» – «Сохранить копию», выбрать папку, в списке типов файла выбрать PDF и нажать «Сохранить» [261].

К списку вопросов ↑

40 Что такое Markdown и почему материалы курса в нём?

Коротко

Markdown – способ размечать обычный текст простыми значками: решётка перед заголовком, звёздочки вокруг жирного слова, дефис перед пунктом списка. Файл остаётся текстовым, его читает человек в любом редакторе и понимает программа, которая делает из него страницу, документ Word или PDF. Курс выкладывает каждый материал в двух видах: HTML – чтобы удобно читать, .md – чтобы работать без интернета, править и передавать языковой модели.

Markdown придумал Джон Грубер при участии Аарона Шварца, выпущен он в 2004 году [262]. Грубер называл его инструментом для авторов веб-текстов: это и правила разметки простого текста, и программа, которая превращает такой текст в HTML [254]. Главным он считал удобство чтения: размеченный документ должен читаться как обычный текст, а образцом служили привычные пометки в электронных письмах [254].

Описание Грубера оставляло спорные случаи, и программы стали понимать один и тот же текст по-разному. Поэтому появилась спецификация CommonMark – строгое и однозначное описание синтаксиса с набором тестов для программ [262]. GitHub описал свой вариант, GitHub Flavored Markdown: он включает весь CommonMark и добавляет расширения, среди них таблицы, списки задач и зачёркнутый текст [263].

Где ещё встречается Markdown:

  • заметки в Obsidian хранятся файлами Markdown (вопрос 32) [168];
  • файлы-инструкции для агентов CLAUDE.md и AGENTS.md пишут в Markdown (вопрос 32) [170], [171];
  • скилл агента – файл SKILL.md: служебная шапка и инструкция в Markdown (вопрос 28) [145];
  • языковые модели часто сами отвечают в Markdown, по наблюдению авторов программы MarkItDown (вопрос 41) [264].

Почему курс выбрал два вида (вывод автора): HTML удобно читать в браузере с телефона и компьютера, а .md удобно хранить у себя, искать по нему, переносить куски в свои документы и прикладывать к запросу модели.

К списку вопросов ↑

41 Почему Markdown удобен для языковых моделей и агентов?

Коротко

В Markdown видно устройство документа – заголовки, списки, таблицы, – а лишнего оформления почти нет. OpenAI советует размечать заголовками и списками Markdown разделы запроса, а модели и сами часто отвечают в Markdown. Исследования говорят осторожнее: модели помогает сохранённая структура документа, а сам формат разметки значит меньше (вывод автора).

Что говорят разработчики:

  • авторы MarkItDown из Microsoft объясняют выбор так: Markdown очень близок к простому тексту, но передаёт устройство документа; крупные модели, по их наблюдению, «говорят» на Markdown и часто сами отвечают в нём, а запись получается экономной по токенам [264]; чисел, насколько экономной, они не приводят;
  • OpenAI в руководстве по запросам пишет, что заголовки и списки Markdown помогают выделить разделы запроса и показать модели их иерархию [74];
  • в документации Claude Code советуют группировать инструкции в файле CLAUDE.md под заголовками и списками Markdown: по словам разработчиков, разбитые на разделы инструкции модели выполнять легче, чем сплошной текст [170];
  • Anthropic отмечает, что оформление запроса влияет на оформление ответа: если убрать Markdown из запроса, в ответе его тоже станет меньше [67]. Для разделения частей сложного запроса – инструкций, контекста, примеров – Anthropic советует теги в стиле XML, например <instructions> и <context> [67]. Markdown – не единственный способ разметки.

Что показывают исследования:

  • PDF и структура. Авторы работы 2026 года отмечают, что формат PDF, в отличие от HTML и Markdown, хранит в первую очередь внешний вид страницы, а не её устройство. Они сравнили, как помощник по документам (вопрос 32) отвечает на 50 вопросов по 36 документам на португальском языке, 1706 страниц. Качество ответов оценивала другая языковая модель по шкале от 0 до 100, средняя оценка – по 50 вопросам и 50 прогонам. При простом извлечении текста из PDF она составила 86,2, для вручную подготовленного Markdown – 91,3, для Markdown от конвертера Docling с делением текста по разделам и описаниями картинок – 94,1 (в этих настройках для ответа извлекали 200 фрагментов). Это средние оценки качества, а не доля полностью правильных ответов. Перевод в Markdown сам по себе успеха не гарантировал: с другими конвертерами даже в лучших настройках оценка была ниже, чем при простом извлечении: 84,0 и 83,2 у двух вариантов MinerU и 79,1 у DeepSeek OCR. При этом деление текста по разделам и сведения о том, из какого раздела фрагмент, дали больше, чем выбор конвертера [265]. Это одна работа: один набор документов, одна модель, а ответы оценивала тоже модель.
  • Формат разметки. В другой работе 2026 года десять моделей проверяли, соответствуют ли научные обзоры перечню требований к ним. С перечнем – в Markdown, JSON, XML или простым текстом – точность была 78,7–79,7 %, без перечня – 45,2 %, а между самими форматами значимой разницы не нашли [266].
  • Мелкие изменения запроса. Ответ модели может измениться даже от лишнего пробела в конце запроса, а просьба выдать ответ в XML в той работе заметно ухудшала результат [70] (вопрос 13).

Вывод автора по этим работам: модели помогает сохранённая структура документа, а конкретный формат разметки, судя по второй работе, значит меньше. Поэтому, прикладывая к запросу длинный документ, лучше дать модели текст с сохранёнными заголовками и таблицами, а не плохо распознанный PDF. Markdown для этого удобен, но проверять ответ всё равно нужно (тема 1.1).

К списку вопросов ↑

42 Как перевести документ Word, PDF или Excel в Markdown и обратно?

Коротко

Для этого есть бесплатные программы с открытым кодом: Pandoc, MarkItDown от Microsoft и утилита автора курса md-converters, построенная на MarkItDown. Все три запускаются на вашем компьютере. При переводе из Word и PDF часть оформления теряется, поэтому результат просматривают, особенно таблицы.

Программа Что переводит в Markdown Обратно из Markdown Что нужно
Pandoc [267] Word (docx), Excel (xlsx), PowerPoint (pptx), HTML и многое другое. PDF не читает Word, PowerPoint, HTML, PDF и другие Установщик для Windows или архив без установки. Для PDF по умолчанию нужен LaTeX, в Windows разработчики рекомендуют MiKTeX; другие способы – через параметр --pdf-engine
MarkItDown [264] PDF, Word, Excel, PowerPoint, HTML, CSV, JSON, XML, EPUB и другие Нет Python 3.10–3.14
md-converters [268] PDF, Word, Excel, PowerPoint, HTML, веб-страницы по адресу, CSV, JSON, XML, EPUB и другие Нет Python 3.10 и новее; для установки через install.ps1 и пункта в меню Проводника – PowerShell 7.2+

Pandoc – «универсальный конвертер документов», свободная программа под лицензией GPL [267]. Примеры команд по документации, с другими именами файлов [267]:

pandoc -s report.docx -t markdown -o report.md
pandoc -s report.md -o report.docx
pandoc report.md -o report.pdf

Первая команда переводит документ Word в Markdown, вторая – обратно в Word, третья делает PDF, если установлен LaTeX. Разработчики предупреждают: при переводе из форматов, которые богаче Markdown, следует ожидать потерь [267].

MarkItDown – программа Microsoft на Python, которая переводит файлы в Markdown для языковых моделей и программ анализа текста. Она сохраняет заголовки, списки, таблицы и ссылки, но, по словам авторов, может не подойти там, где нужен точный внешний вид документа для человека [264]. Команда для перевода: markitdown report.pdf -o report.md. Встроенные конвертеры работают без интернета, а описание картинок, перевод речи в текст и облачные службы Azure отправляют данные наружу, причём службы Azure платные [264]. Авторы предупреждают, что программа читает всё, к чему есть доступ у запустившего её пользователя, поэтому чужие и непроверенные файлы и адреса ей передают с осторожностью [264].

md-converters – утилита автора курса, версия 1.4.0, лицензия MIT, построена на MarkItDown [268]. Одна команда tomd сама определяет формат по расширению: tomd report.docx кладёт report.md рядом с исходным файлом, tomd * переводит все поддерживаемые документы в текущей папке, а ключ -r добавляет вложенные папки. Установщик может добавить пункт «Конвертировать в Markdown» в меню правой кнопки мыши, если вы на это согласитесь, а для тех, кто не любит командную строку, есть необязательная страница в браузере, куда файлы перетаскивают мышью; её ставят отдельно. В описании утилиты сказано и об ограничении: если PDF – скан без текстового слоя, Markdown получится пустым или с мусором, такой файл сначала распознают [268].

Как получить из Markdown файл PDF без LaTeX (вывод автора): перевести его в Word через Pandoc или в веб-версии Word (вопрос 38), а затем сохранить из Word в PDF (вопрос 39).

Перед работой проверьте результат:

  1. Таблицы. В исследовании конвертеров PDF сильнее всего результаты расходились на вопросах по таблицам, а простое извлечение текста путало таблицы с объединёнными ячейками [265].
  2. Сканы. Из PDF без текстового слоя, то есть из отсканированных страниц, без распознавания получится пустой файл или мусор [268]. Проверить просто: если текст в PDF не выделяется мышью, текстового слоя, скорее всего, нет (вывод автора).
  3. Числа и единицы измерения – сверьте с исходником.

Эти программы на рабочий компьютер ставит ИТ-служба или сам сотрудник с разрешения организации (тема 2.1). Режимы, которые отправляют файл в облако, для рабочих документов годятся только по правилам организации.

К списку вопросов ↑

43 Как пишется Markdown? Короткая шпаргалка

Коротко

Достаточно десятка приёмов: решётки для заголовков, звёздочки для выделения, дефисы и цифры для списков, вертикальные черты для таблиц, квадратные и круглые скобки для ссылок, обратные апострофы для команд. Ниже – как это пишется по спецификации CommonMark и документации GitHub.

Что нужно Как написать Источник
Заголовок От одного до шести знаков # и пробел: # Заголовок, ## Подзаголовок [269]
Жирный шрифт **текст** или __текст__ [269]
Курсив *текст* или _текст_ [269]
Список Каждый пункт с новой строки, в начале -, * или + и пробел [269]
Нумерованный список 1., 2. и пробел в начале строки [269]
Список задач - [ ] – не сделано, - [x] – сделано [269]
Ссылка [текст ссылки](адрес) [269]
Цитата > в начале строки [269]
Команда или имя файла в строке Обратные апострофы с двух сторон: `tomd report.docx` [269]
Блок кода Три обратных апострофа на отдельной строке до блока и столько же после [269]
Таблица Строки с вертикальными чертами, под шапкой – строка из дефисов [270]

Так выглядит небольшой документ:

## Протокол испытаний: краткая сводка

**Объект:** блок питания, партия 12.

Замечания:

- выходное напряжение в норме;
- температура корпуса выше допуска.

| Параметр | Норма | Факт |
|---|---|---|
| Напряжение, В | 24 ± 0,5 | 24,2 |
| Температура, °C | до 60 | 63 |

Справка по синтаксису: [CommonMark](https://commonmark.org/help/)

Правила, о которые спотыкаются чаще всего:

  • таблицы не входят в базовую спецификацию CommonMark, это расширение GitHub Flavored Markdown [263]; GitHub их понимает, а программа, которая следует только CommonMark, может показать таблицу простым текстом (вывод автора);
  • перед таблицей нужна пустая строка, а в строке под шапкой – не меньше трёх дефисов в каждом столбце; двоеточие слева, справа или с двух сторон от дефисов выравнивает столбец [270];
  • новый абзац начинают после пустой строки; обычный перенос строки внутри абзаца по спецификации CommonMark обычно отображается как пробел, а чтобы явно перенести строку, перед переносом ставят два пробела или обратную косую черту; отображение может зависеть от настроек программы [262].

Краткая справка и интерактивный учебник – на сайте CommonMark [262].

К списку вопросов ↑

Ссылки

Источники

Все ссылки страницы. Сведения о сервисах, ценах и условиях – на дату, указанную в группе: они меняются часто.

Нумерация общая для всей страницы, номер – по первому упоминанию.

Научные публикации

Препринты отмечены; остальные работы прошли рецензирование. Ссылки – через doi.org.

Нормативные документы и стандарты

Документация и страницы разработчиков и сервисов

Страницы открыты 15–16.11.2026. Цены, тарифы и условия меняются часто: перед решением сверяйте их на самих страницах.

Программы и инструменты

Страницы открыты 15–16.11.2026.

Данные для замера

  • [33] Замер автора, 15.11.2026. Статьи 1–30 декларации ООН в токенизаторах открытых моделей qwen3.5:9b, gemma3:4b, gpt-oss:20b и deepseek-r1:14b (программа Ollama 0.40.16, число токенов запроса; служебный токен начала текста вычтен). Разбиение слов – токенизатором Qwen 2.5 (библиотека transformers); его счёт на тексте декларации совпал с deepseek-r1:14b. Длина векторов – по сведениям ollama show (embedding length): gemma3:4b – 2560, gpt-oss:20b – 2880, qwen3.5:9b – 4096, deepseek-r1:14b – 5120. ↩ к тексту
  • [40] ООН. Всеобщая декларация прав человека, официальные тексты на русском и английском. https://www.un.org/ru/about-us/universal-declaration-of-human-rights ; https://www.un.org/en/about-us/universal-declaration-of-human-rights ↩ к тексту